YOLO学习
# YOLO介绍
# 为什么需要YOLO
在YOLO出现之前,目标检测主要靠“R-CNN系列”算法。你可以把以前的算法想象成“拿着放大镜找东西”:
旧方法(Two-stage):先在图片上生成几千个可能包含物体的“候选框”(Region Proposal),然后把这些框一个个切下来,分别放进神经网络去识别。这就像你在操场上找人,先圈出1000个区域,再挨个区域仔细看。缺点:太慢了,无法实时。
YOLO(One-stage):“一眼看全图”。它不需要生成候选框,而是把整张图片直接扔进神经网络,网络一次性输出所有物体的位置和类别。这就像你扫一眼操场,瞬间就知道谁在哪里。优点:极快,能实现实时检测(45帧/秒以上)。
核心概念补充:
FPS (Frames Per Second):每秒传输帧数。数值越大,视频越流畅。YOLO能达到45 FPS,意味着它处理一张图只需要约22毫秒,人眼根本感觉不到卡顿。
mAP (mean Average Precision):平均精度均值。用来衡量检测准不准的指标,数值越高越好。
# YOLOv1 是怎么工作的?(核心思想)
YOLO的全称是 You Only Look Once(你只看一次)。它的核心思想是将目标检测任务转化为一个回归问题。
- 网格划分
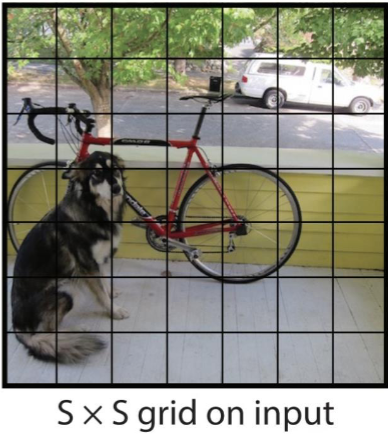
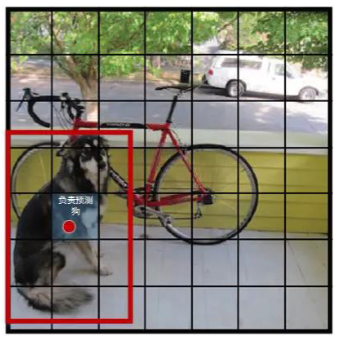
YOLO把输入图片(统一调整为 448×448)划分成一个 S×S 的网格。图中,S=7,所以图片被分成了 49个小格子。
- 责任归属原则(非常重要!)
这是YOLO最聪明的地方:如果一个物体的中心点落在了某个格子里,那么这个格子就负责预测这个物体。
- 举例:如果一只狗的中心点在左上角的格子里,那么只有左上角那个格子会输出“这里有只狗”,其他格子都会忽略这只狗。
- 好处:不用设计很大的框去覆盖整个物体,只需要关注中心点在哪即可。
- 每个格子预测什么?
每个格子不仅要判断“有没有物体”,还要预测“物体在哪”和“是什么”。具体来说,每个格子要预测:
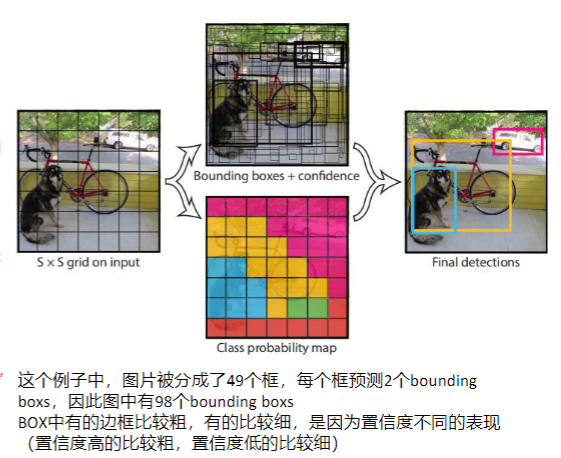
B个边界框:设定 𝐵=2 。也就是每个格子猜两个框,看哪个更准。
置信度:表示这个框里“有物体的可能性”以及“框得准不准”。
C个类别概率:如果是VOC数据集,有20种物体(猫、狗、车等),就要输出20个概率值。
# 网络的输出到底是什么?
这是很多初学者的噩梦,我们用Python列表的思维来理解。
假设图片被分成 7×7 的网格,每个格子预测 2 个框,类别有 20 种。
那么对于每一个格子,它输出的数据长度是:
2×(4个坐标+1个置信度)+20个类别概率=30
- 4个坐标:(x,y,w,h) ,分别是中心点坐标和宽高。
- 1个置信度:Confidence。
- 20个类别:比如 [猫:0.1, 狗:0.8, 车:0.01 ...]。
所以,整张图的输出就是一个 7×7×30 的三维张量。
- 前两个7×7 代表空间位置(对应图片上的49个格子)。
- 最后的 30 代表每个格子的详细信息。
# 损失函数(模型怎么知道自己错了?)
模型刚开始是瞎猜的,我们需要告诉它“你错哪了”,这就是损失函数。YOLOv1的损失函数由三部分组成,我们可以把它看作三个扣分项:
- 坐标误差:
- 如果你预测的框中心 (𝑥,𝑦) 和真实框中心差得远,扣分。
- 如果你预测的宽高 (𝑤,ℎ) 和真实框差得远,扣分。
- 细节:对 𝑤,ℎ 取了根号。这是因为大框差一点像素没关系,但小框差一点像素就很严重了,开根号是为了让小框的误差也被重视。
- 置信度误差:
- 有物体的格子:如果你预测的置信度不高(明明有狗,你却说不确定),扣分。
- 没物体的格子:如果背景里啥也没有,你却自信满满地说有东西,扣分(这项权重通常设得比较低,因为背景太多了)。
- 分类误差:
如果格子里有物体,但你把“狗”认成了“猫”,扣分。
# YOLOv1 的总结:成也萧何,败也萧何
速度极快,但定位不准。
优点(为什么它革命性?)
- 快:因为它把检测变成了回归问题(直接算坐标),而不是像以前那样一个个框去试。YOLO能达到45 FPS(每秒45帧),而当时的Faster R-CNN只有7 FPS。
- 背景错误少:Fast R-CNN经常把背景误认为是物体(Background error高),而YOLO看的是整张图,它能理解“这里虽然有个纹理,但它是背景”,所以误报少。
- 泛化能力强:因为它学习了物体的通用特征,哪怕你把画风的图给它,它也能认出来。
缺点(为什么后来要改?)
- 小物体检测差:这是YOLOv1最大的死穴。狗和自行车的图很经典。因为图片被分成了7x7的网格,如果一只小狗的中心点落在一个格子里,这个格子就必须负责预测这只狗。但如果这个格子里其实有两只小狗呢?YOLOv1的一个格子只能预测2个框,且最终只输出1个物体,所以必然有一只狗会被漏掉。
- 定位不够精准:因为它直接用全连接层输出坐标,对边界框的边缘处理比较粗糙。
# 两个必须懂的概念:IOU 和 NMS
这部分是目标检测的通用知识,不管以后学什么算法都要用。
IOU:交并比
- 是什么:用来衡量“你预测的框”和“真实框”重合程度的指标。
- 公式解读: IOU=A∩B/A∪B。别被符号吓到,其实就是:两个框重叠的面积除以两个框加起来的总面积。
- 直观理解:
- 如果IOU=1,说明完全重合,完美预测。
- 如果IOU=0,说明两个框完全不沾边。
- 一般我们设定一个阈值(比如0.5),IOU大于0.5才算预测对了。
NMS:非极大值抑制
- 解决什么问题:你看图里那张人脸检测的图,如果不处理,一张脸上会叠着几十个框,密密麻麻根本没法用。NMS就是用来“去重”的。
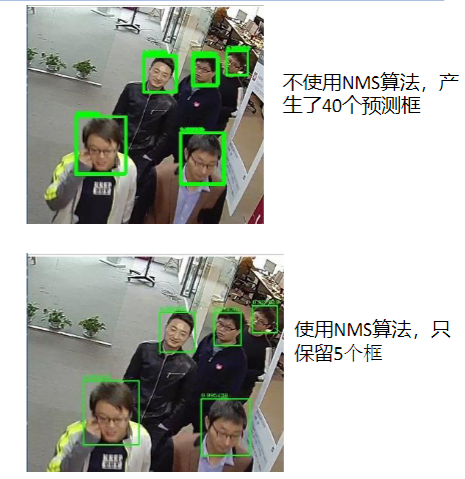
操作步骤(通俗版):
- 排序:把所有预测框按“置信度”(也就是模型觉得它是对的的概率)从高到低排队。
- 选老大:拿出分数最高的那个框(比如图里最清晰的那个人脸),把它留下。
- 消灭小弟:拿着这个“老大”框,去跟剩下的框算IOU。如果某个框跟“老大”重叠太多(比如IOU>0.5),说明它们指的是同一个东西,直接把那个分数低的删掉。
- 循环:从剩下的框里再找分数最高的,重复上面的步骤,直到所有框都处理完。
# YOLOv3 的改进:多尺度预测
YOLOv3,这是YOLO系列的一个里程碑。
为什么要改?
为了解决YOLOv1“小物体检测差”的问题。
怎么改的?——多尺度预测
YOLOv1的做法:只把图片分成7x7的大格子。大格子感受野大,适合看大物体,但看不清小物体。
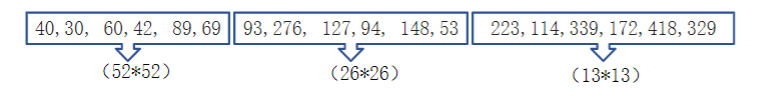
YOLOv3的做法:它在三个不同的尺度上进行预测(13x13, 26x26, 52x52)。
- 13x13(大格子):负责检测大物体(如车、人)。
- 52x52(小格子):格子非常密,专门负责检测小物体(如远处的鸟、交通标志)。
Anchor Boxes(锚框):图里那一串数字(40,30...)是预设的框的大小。YOLOv3不再让网络瞎猜框的大小,而是先告诉网络:“大概有这么几种长宽比的框”,网络只需要在这些基础上微调即可。这大大提高了定位的准确性。