阶段一:后端基建与混合记忆库 (向量 + 图谱)
# 里程碑 1:搭建本地 AI 基础设施
目标:在你的电脑上跑起两个核心数据库。
你需要完成:
- 确保你的电脑上安装了 Docker 和 Docker Compose。
- 编写一个 docker-compose.yml 文件,一键启动 Qdrant(向量数据库)和 Neo4j(图数据库)。
- 验证:打开浏览器,能成功访问 Qdrant 的控制台(默认 6333 端口)和 Neo4j 的浏览器(默认 7474 端口)。
# 知识点扫盲
Docker
通俗理解:想象你要运东西(安装软件),以前你需要自己造轮子、配环境,很容易出错。Docker 就像一艘巨大的运输船,它把软件连同它需要的所有零件都装在一个“集装箱”(镜像)里。你只需要把船开过来,一键卸货,软件就能完美运行。
你需要学会:如何安装 Docker Desktop,以及两个最简单的命令:docker-compose up -d(把船靠岸,卸下集装箱并后台运行)和 docker-compose down(把集装箱装回船上带走/停止运行)。
向量数据库 Qdrant(高维图书馆)
通俗理解:普通数据库存的是“字”,比如“苹果”。向量数据库存的是“意思”,它会把“苹果”转化成一串数字(比如 [0.12, 0.85, ...],这叫向量)。在这个图书馆里,你不需要知道书名,只要你描述“一种红色的、甜甜的水果”,它就能通过计算数字之间的距离,瞬间帮你找到“苹果”。
你需要学会:不需要懂复杂的数学。你只需要知道,我们把文档变成了一堆数字扔进了这个仓库,以后靠“语义相似度”来找资料。
图数据库 Neo4j(超级关系网)
通俗理解:如果向量数据库是图书馆,那图数据库就是一张巨大的“人物关系图”或者“地铁线路图”。它不关心“意思”,它关心“关系”。比如“马斯克” -> “是CEO” -> “特斯拉”。它专门用来存这种谁和谁有关系的数据。
你需要学会:理解“节点”(图上的点,比如人名、公司名)和“边”(图上的连线,比如“任职于”)这两个概念就够了。
环境变量与端口(门牌号与钥匙)
通俗理解:你的电脑就像一个大楼,Qdrant 和 Neo4j 是住在大楼里的两个租客。为了防止客人走错门,它们分别占了 6333 和 7474 这两个房间(这就是端口 Port)。另外,为了安全,进入房间需要密码(这就是环境变量,比如 NEO4J_PASSWORD)。
你需要学会:在配置文件中正确设置端口映射和密码。
# 安装Docker
https://www.docker.com/products/docker-desktop/ (opens new window)下载安装包
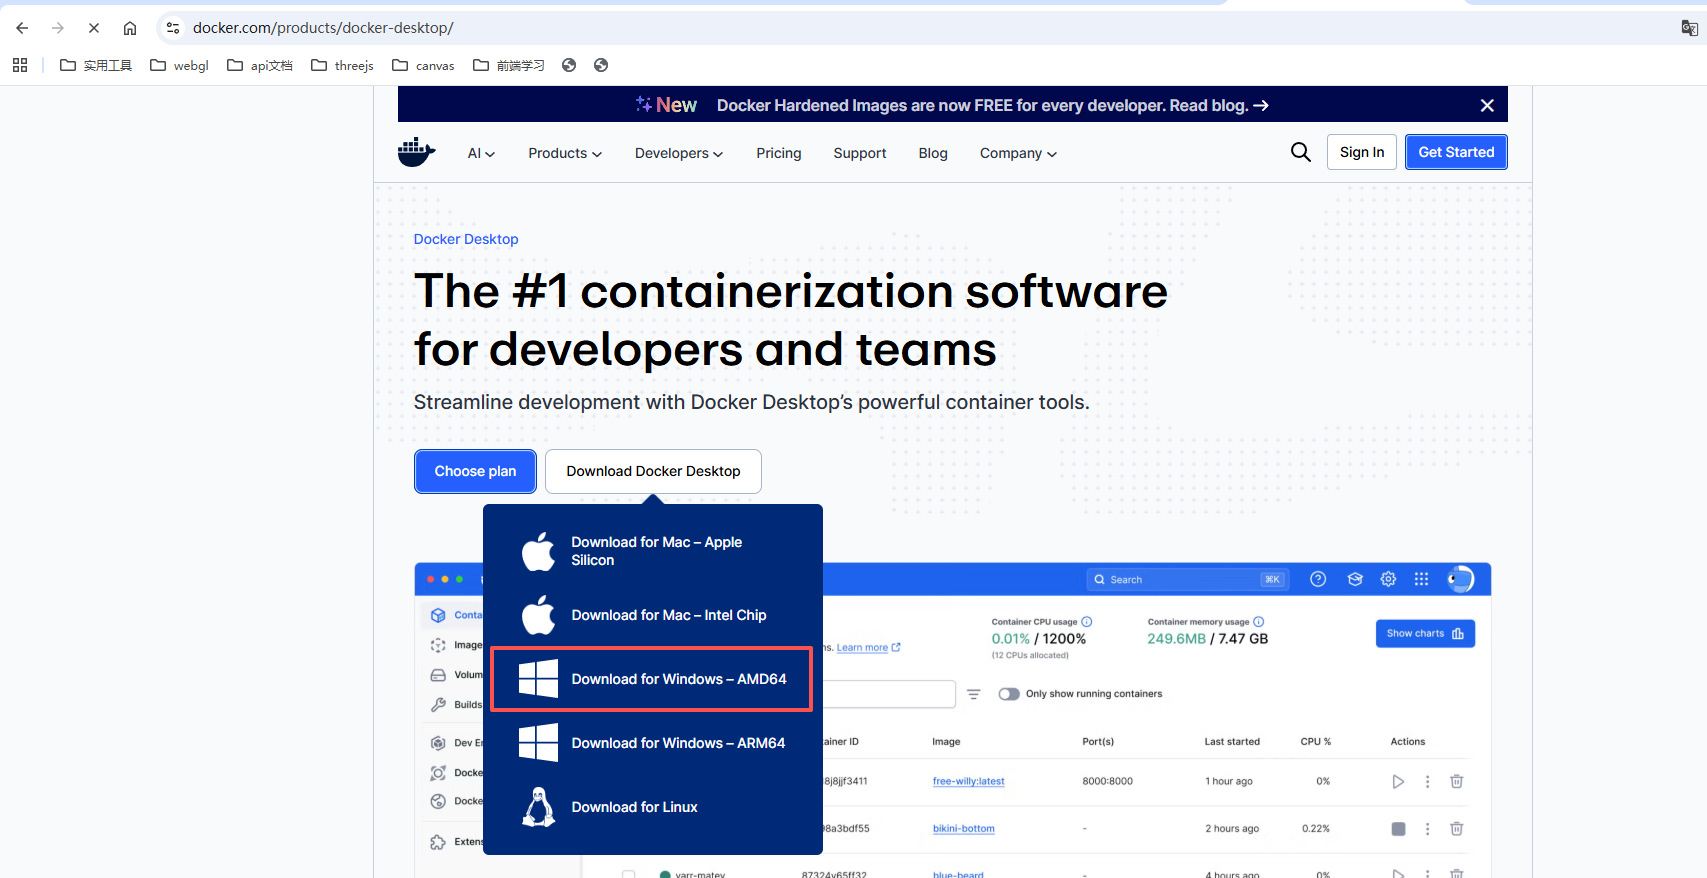
双击安装包开始安装,选择「Use WSL 2 instead of Hyper-V」(如果系统提示需要启用WSL,按照提示完成操作)
安装完成后,Docker会自动启动,你可以在任务栏右下角看到Docker的鲸鱼图标
打开Docker,进入配置页面,进入Docker Engine,将配置修改为,这一步是改为国内源
{
  "debug": false,
  "experimental": false,
  "insecure-registries": null,
  "registry-mirrors": [
    "https://docker.m.daocloud.io",
    "https://registry.docker-cn.com",
    "https://hub-mirror.c.163.com",
    "https://docker.mirrors.ustc.edu.cn"
  ]
}
2
3
4
5
6
7
8
9
10
11
点击Apply重启Docker
注意
如果打开docker的界面出现这个不要慌
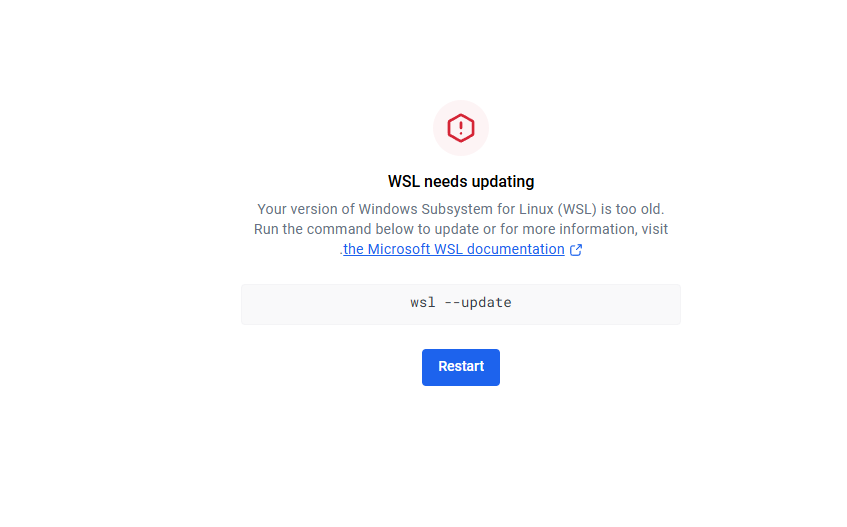
解决方法:
- 启用适用于 Linux 的 Windows 子系统
必须先启用“适用于 Linux 的 Windows 子系统”可选功能,然后才能在 Windows 上安装任何 Linux 分发版。 以管理员身份打开 PowerShell (> PowerShell > 右键单击 > 以管理员身份运行) 并输入以下命令:
dism.exe /online /enable-feature /featurename:Microsoft-Windows-Subsystem-Linux /all /norestart
- 打开PowerShell(右键开始菜单选择Windows PowerShell),输入以下命令并回车:
wsl --update
更改docker存放镜像位置
- 打开设置:在 Docker Desktop 的界面右上角,点击小齿轮图标(Settings)。
- 找到资源选项:在左侧菜单栏选择 Resources(资源)。
- 修改路径:在右侧找到 Disk image location(磁盘映像位置)。点击 Browse(浏览)或者直接输入你想存放的路径(比如 D:\DockerImages)。
- 保存并重启:点击右下角的 Apply & Restart。Docker 会自动把原有的镜像文件搬到你指定的新盘里,重启完成后就生效了。
# Docker基础操作
从0开始,那我们把 Docker 想象成一个"超级集装箱码头"。
你现在的电脑就是这块地皮,Docker 就是那个管理码头的工头。
我们不需要背复杂的命令,只需要掌握 "4个核心动作",你就能驾驭它。
- 核心概念
在操作之前,先搞懂三个词,不然一会儿看命令会晕:
镜像:就像游戏的安装包(比如 qdrant 的安装包)。它是只读的,不能直接改。
容器:就像运行中的游戏。你用安装包启动了一个程序,这个运行状态就是容器。你可以随时暂停、删除它,而不影响安装包。
仓库:就像 App Store。Docker Hub 就是官方商店,里面有全世界开发者上传好的现成镜像。
- 实操演练:从0到1启动你的第一个服务
我们要用 Docker 跑一个最简单的 Web 服务器(Nginx),这比直接跑数据库更直观,能让你瞬间明白 Docker 是怎么工作的。
请打开你的终端(Windows 下推荐用 PowerShell 或 CMD,Mac 用 Terminal),跟着我敲下面这几行命令:
- 第一步:拉取镜像(下载安装包)
docker pull nginx
含义:去 Docker Hub 商店里,把 nginx 这个软件的安装包下载到本地。
现象:你会看到一堆下载进度条。
第二步:启动容器(运行程序)
docker run -d -p 8080:80 --name my-web-server nginx
docker run:启动一个容器。-d:后台运行(Daemon)。如果不加这个,你的终端窗口会被它占满,关窗口服务就停了。-p 8080:80:端口映射(重点!)。- 冒号右边的 80 是容器内部的端口(Nginx 默认在 80 端口接客)。
- 冒号左边的 8080 是你电脑的端口。
- 意思是:把你电脑 8080 端口的流量,转发到容器里的 80 端口。
--name my-web-server:给这个容器起个名字,方便以后找它。nginx:指定用哪个镜像启动。第三步:验证成果
打开浏览器,访问 http://localhost:8080 (opens new window)。
如果你看到了 "Welcome to nginx!" 的页面,恭喜你!你已经成功在 Docker 里跑起了一个服务。第四步:管理容器(生杀大权)
现在你的电脑里有一个正在运行的容器,我们来试试管理它:- 查看正在运行的容器:
docker ps1你会看到刚才那个 my-web-server 躺在列表里。
- 查看日志(排查报错神器):
docker logs my-web-server1如果服务起不来,用这个命令看它吐出了什么错误信息。
- 停止容器:
docker stop my-web-server1再刷新浏览器,网页就打不开了。
- 删除容器:
docker rm my-web-server1注意:如果容器还在运行,得加 -f 强制删除。
- 为什么我们需要 Docker Compose?
刚才我们只用了一行命令就启动了 Nginx,很简单对吧?
但是,回想一下我们的目标:Qdrant + Neo4j。
如果你不用 Docker Compose,你需要:
手动敲一行长长的命令启动 Qdrant,还要记端口、记挂载路径。
再手动敲一行更长的命令启动 Neo4j,还要设置环境变量密码。
下次换个电脑,或者想把这个项目发给朋友,你得发给他两个脚本,还得告诉他“先跑第一个,再跑第二个”。
Docker Compose 的作用就是:
把上面那两行复杂的命令,写进一个 docker-compose.yml 文件里。以后不管在哪台电脑上,只要执行一句 docker compose up -d,所有服务自动按顺序启动,配置完全一致。
# Docker Compose 配置文件的编写规则(万能公式)
docker-compose.yml 文件本质上就是一个“清单”,你只需要按照固定的格式,告诉 Docker “我要启动什么镜像”、“启动时要带哪些参数” 就行了。
你可以把它想象成在填一张表格。只要记住下面这个“万能模板”,下次你想启动任何软件(比如 MySQL、Redis、MongoDB),只需要替换里面的名字和端口即可:
version: '3.8'  # 语法版本,通常写死这个就行

services:       # 固定关键词:下面定义所有的“服务”(也就是容器)

  # 1. 给你的服务起个代号(随便起,比如 my_db)
  my_db:
    image: xxx  # 【必填】镜像的名字(去 Docker Hub 上搜,比如 mysql, redis, neo4j)
    container_name: xxx # 【选填】给运行起来的容器起个名字,方便管理
    ports:      # 【选填】端口映射,格式是 - "宿主机端口:容器内部端口"
      - "8080:80"
    environment:# 【选填】环境变量,通常用来设置密码、配置项
      - KEY=VALUE
    volumes:    # 【选填】数据卷挂载,格式是 - "宿主机路径:容器内部路径"
      - ./data:/data
    restart: always # 【选填】如果 docker 重启了,这个容器也要自动重启
2
3
4
5
6
7
8
9
10
11
12
13
14
15
怎么查文档?
下次你要启动一个新软件(比如 MySQL),你只需要去 Docker Hub 搜索 mysql,点开官方镜像,往下滑找到 “docker-compose.yml” 或者 “Environment Variables” 章节,把里面的参数抄过来改一改就行了。
没下载镜像,能直接启动吗?
这正是 Docker Compose 最智能的地方。当你输入 docker compose up -d 时,Docker 会在后台自动执行以下逻辑:
- 它会先看你的电脑里有没有 qdrant:latest 和 neo4j:5.15.0 这两个镜像。
- 如果没有,它会自动帮你执行 docker pull 去网上下载。
- 下载完成后,它再自动帮你执行 docker run 把它们启动起来。
所以,你不需要手动去敲 docker pull qdrant,一条 docker compose up -d 就全包了。你会发现终端里会有进度条在走,那就是在下载镜像。
# 启动 Qdrant 和 Neo4j 这两个关键组件
- 第一步:创建项目目录
我们需要一个专门的地方来存放配置文件和数据。请在终端(PowerShell 或 CMD)中执行以下命令:
# 1. 进入你想存放项目的目录(比如 D盘)
D:

# 2. 创建一个名为 rag-project 的文件夹
mkdir rag-project

# 3. 进入这个文件夹
cd rag-project
2
3
4
5
6
7
8
- 第二步:编写"编排剧本"
在这个文件夹里,我们需要创建一个名为 docker-compose.yml 的文件。这是 Docker Compose 的配置文件,它告诉 Docker 如何启动这两个数据库。
你可以使用记事本或 VS Code 创建这个文件,并将以下内容复制进去:
# 指定 Docker Compose 文件格式版本为 3.8。这是目前广泛支持的版本,兼容大多数 Docker Engine。
version: '3.8'

services:
  # --- 1. Qdrant 向量数据库 ---
  qdrant:
    image: qdrant/qdrant:latest  # 指定使用的镜像名称和标签。qdrant/qdrant:latest 表示从 Docker Hub 拉取官方最新版的 Qdrant 镜像。
    container_name: rag-qdrant # 为这个容器指定一个固定名称 rag-qdrant,方便后续通过名称管理
    ports:
      - "6333:6333"  # 将电脑的6333端口映射到容器的6333端口
    volumes:
      - ./data/qdrant:/qdrant/storage  # 数据持久化:防止重启后数据丢失
    restart: always # 容器退出后自动重启。

  # --- 2. Neo4j 图数据库 ---
  neo4j:
    image: neo4j:5.15.0 # 使用 Neo4j 官方镜像的 5.15.0 版本。指定版本号可以避免因版本更新导致的兼容性问题。
    container_name: rag-neo4j
    ports:
      - "7474:7474"  # Neo4j 浏览器访问端口
      - "7687:7687"  # 应用程序连接端口(Bolt协议)
    environment:
      - NEO4J_AUTH=neo4j/your_password  # 设置初始密码,请修改 'your_password',注意这个密码要8位
      - NEO4J_server_http_enabled=true   # <--- 加上这一行,强制开启 HTTP
    volumes:
      - ./data/neo4j:/data  # 数据持久化
    restart: always
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
- ports: 就像给集装箱开了个窗户,让你能从电脑访问里面的服务。
- volumes: 就像给集装箱接了个外接硬盘。如果不写这一行,你一旦删除容器,里面的数据就全没了!
- environment: 这里设置了 Neo4j 的密码,记得把 your_password 改成你自己想用的密码。
为什么Neo4j有两个端口?
- 7474:7474:这是 HTTP 端口,用于访问 Neo4j 的 Web 管理界面(Neo4j Browser)。你可以在浏览器中打开 http://localhost:7474,输入用户名密码后,可视化地查询和管理图数据。
- 7687:7687:这是 Bolt 协议端口。Bolt 是 Neo4j 专为高性能、低延迟设计的二进制协议,用于应用程序(如 Python、Java、Go 等)与数据库进行通信。它比 HTTP 更快、更高效,适合生产环境的数据读写操作。
Bolt 协议是什么?
Bolt 是 Neo4j 的原生协议,类似于 PostgreSQL 的 PGWire 或 MySQL 的 MySQL Protocol。它支持事务、流式结果、参数化查询等高级功能,是推荐的生产级连接方式。
关于 Volumes 的补充说明
宿主机路径:./data/qdrant 和 ./data/neo4j 是相对于你执行 docker-compose up 命令的目录。例如,如果你在 E:\rag-project 目录下运行命令,那么数据会实际存储在:
- Qdrant 数据:E:\rag-project\data\qdrant
- Neo4j 数据:E:\rag-project\data\neo4j
容器内路径:/qdrant/storage 和 /data 是容器内部的虚拟文件系统路径,由 Docker 管理,你无需关心其物理位置。
- 第三步:一键启动 保存好文件后,回到终端(确保你在 rag-project 目录下),输入以下命令并回车:
docker compose up -d
- up: 表示启动服务。
- -d: 表示在后台运行,这样你的终端窗口就不会被日志占满,可以继续干别的事。
- 验证
命令执行完后,如果没有报错,你可以打开浏览器验证一下:
检查 Qdrant: 访问 http://localhost:6333/dashboard (opens new window)
如果看到一个类似仪表盘的界面,说明向量数据库启动成功。检查 Neo4j: 访问 http://localhost:7474 (opens new window)
输入用户名 neo4j 和你刚才设置的密码。
如果能登录进去看到代码输入框,说明图数据库启动成功。
# 里程碑 2:多模态文档解析与智能切片
目标:把一份复杂的 PDF 变成干净的、带有标题层级的文本块(Chunks)。
你需要完成:
准备一份测试用的复杂 PDF 文件(比如包含表格的公开财报)。
编写 doc_parser.py,使用 Docling 或 Unstructured 库解析这份 PDF。
编写切片逻辑:不要按固定字数切!要根据 Markdown 的标题(H1, H2, H3)进行语义切片,确保每个切片是一个完整的段落。
验证:运行脚本,打印出前 3 个切片的内容,检查表格有没有乱码,段落有没有被拦腰截断。
# 项目环境准备
第一步:用 PyCharm 打开项目文件夹,就是刚刚docker-compose.yml在的那个文件夹
- 打开 PyCharm。
- 点击 File -> Open。
- 选择项目文件夹如E:\rag-project。
- 如果 PyCharm 问你“是否信任此项目”,点 Trust Project。
第二步:配置 PyCharm 专属的虚拟环境 (venv)
- 点击右下角的解释器状态栏(通常显示 No interpreter 或 Python 3.x)。
- 选择 Add New Interpreter -> Add Local Interpreter...。
- 在弹出的窗口左侧选择 Virtualenv Environment。
- 关键设置:
- Location: 保持默认(它会自动生成在 E:\rag-project.venv)。
- Base interpreter: 选择你电脑上安装的 Python 3.10 或更高版本(Docling 需要较新的 Python)。
- 点击 OK。PyCharm 会自动帮你创建并激活这个环境。
第三步:在 PyCharm 的终端里安装 Docling
现在环境配好了,我们需要在这个环境里装库。- 点击 PyCharm 底部的 Terminal 标签页。
- 你会看到命令行前面有一个 (.venv),这说明环境激活成功了。
- 输入以下命令并回车:
pip install docling1(注:如果下载慢,可以加国内源:pip install docling -i https://pypi.tuna.tsinghua.edu.cn/simple)
# 获取上市公司财报
- 打开 巨潮资讯网(网址:http://www.cninfo.com.cn/ (opens new window)),这是证监会指定的官方披露平台。
- 在搜索框输入任意一家知名公司的名字或代码,比如输入 贵州茅台 或 600519。
- 点击“公告”,在分类里勾选“年度报告”。
- 随便点开一份最新的年报,直接下载 PDF 即可。这种 PDF 里面表格极多,非常适合用来测试 Docling 的解析能力。
# docling的原理和使用
Docling 是一个专为生成式 AI 设计的开源文档解析与转换工具,由 IBM Research Zurich 团队开发,其核心目标是将 PDF、DOCX、PPTX、HTML 等非结构化文档,转换为机器可理解、结构清晰的 Markdown 或 JSON 格式,特别适合用于 RAG(检索增强生成)和 LLM(大语言模型)的知识库构建。
- Docling 能实现什么功能?
把它想象成一个"超级复印扫描员 + 翻译官"。
普通的 PDF 读取工具(比如早期的 PyPDF2)就像是"盲人摸象",它只能摸到一堆零散的文字,根本不知道哪段是标题,哪段是表格,也不知道图片在哪。
而 Docling 能做到:
- 结构识别:它能精准识别出文档的"骨架"。比如:这是 H1 大标题,那是 H2 小标题,这一块是正文,那一块是页脚。
- 表格还原:这是它最厉害的地方!财报里那种跨页的、合并单元格的复杂表格,它能直接给你还原成规整的 Markdown 表格(用 | 符号排好那种)。
- 公式与图片:它能识别出这里有个数学公式,那里有张架构图,并把它们的位置标记出来。
- 格式转换:把死板的 PDF,直接翻译成 AI 最爱吃的 Markdown 格式。
它的工作流是: PDF 二进制文件 -> Docling 视觉分析 -> 结构化对象 (Document Object) -> 导出为 Markdown / JSON
为什么它这么厉害?
因为它不是靠"读文字",而是靠"看画面"。
传统的工具是在提取文字,而 Docling 背后运用了计算机视觉(CV)技术。它把 PDF 的每一页当成一张图片来看,利用先进的深度学习模型去"看见"页面上的布局。它"看"到了一堆方框和线条,就能判断出"哦,这是一个表格",然后再把里面的文字提取出来组装好。
- Docling 的核心 API 介绍
Docling 的 API 设计非常简洁,核心类是 DocumentConverter,主要方法如下:
- 初始化转换器
from docling.document_converter import DocumentConverter
converter = DocumentConverter()
2
支持自定义配置,如启用 OCR、指定输出格式等。
- 转换文档
result = converter.convert("path/to/your/file.pdf")
支持本地文件路径、URL、甚至二进制流。首次运行会自动下载 AI 模型(约 1-3 分钟)。
- 导出结果
# 导出为 Markdown(RAG 最推荐)
markdown_text = result.document.export_to_markdown()

# 导出为 JSON(保留完整结构)
json_data = result.document.export_to_dict()

# 导出为 HTML(带图片嵌入)
html_text = result.document.export_to_html()
2
3
4
5
6
7
8
- 批量处理(可选)
from concurrent.futures import ThreadPoolExecutor

def process_batch(pdf_paths):
    converter = DocumentConverter()
    with ThreadPoolExecutor(max_workers=4) as executor:
        futures = {executor.submit(converter.convert, path): path for path in pdf_paths}
        for future in futures:
            result = future.result()
            print(result.document.export_to_markdown()[:500])
2
3
4
5
6
7
8
9
# 使用docling解析企业年报
实际我在使用的时候,遇到了内存不足的问题,然后为了更好的溯源,我是1页1页解析的
import gc
import torch


from docling.document_converter import DocumentConverter, PdfFormatOption
from docling.datamodel.base_models import InputFormat
from docling.datamodel.pipeline_options import PdfPipelineOptions, AcceleratorOptions, AcceleratorDevice


def parse_pdf_page_by_page(pdf_path):
    """
    逐页解析 PDF,逻辑极简,溯源绝对精确
    """
    # 1. 配置 Pipeline 和 GPU
    pipeline_options = PdfPipelineOptions()
    pipeline_options.accelerator_options = AcceleratorOptions(device=AcceleratorDevice.CUDA)

    converter = DocumentConverter(
        format_options={InputFormat.PDF: PdfFormatOption(pipeline_options=pipeline_options)}
    )

    # 2. 获取 PDF 真实总页数
    try:
        import fitz
        doc = fitz.open(pdf_path)
        total_pages = len(doc)
        doc.close()
        print(f"📄 检测到文档共有 {total_pages} 页,准备逐页解析...")
    except ImportError:
        print("⚠️ 未安装 PyMuPDF,建议运行: pip install pymupdf")
        return ""

    all_markdown = []

    # 3. 逐页循环解析
    for page_num in range(1, total_pages + 1):
        print(f"🚀 正在解析第 {page_num}/{total_pages} 页...")

        try:
            # 每次只传 1 页
            result = converter.convert(pdf_path, page_range=(page_num, page_num))
            md_text = result.document.export_to_markdown()

            # 打上精确的单页标签
            page_tag = f"\n\n<!-- PAGE: {page_num} -->\n\n"
            all_markdown.append(page_tag + md_text)

        except Exception as e:
            print(f"❌ 第 {page_num} 页解析失败: {e}")

        # 强制清理显存(虽然 1 页占用不大,但养成好习惯)
        gc.collect()
        if torch.cuda.is_available():
            torch.cuda.empty_cache()

    return "".join(all_markdown)


if __name__ == "__main__":
    pdf_file = "贵州茅台:贵州茅台2025年年度报告.pdf"
    print("⏳ 开始逐页解析,请耐心等待...")
    full_text = parse_pdf_page_by_page(pdf_file)

    if full_text:
        with open("maotai_full_report.md", "w", encoding="utf-8") as f:
            f.write(full_text)

        print("\n🎉 全部解析完成!已保存为 maotai_full_report.md")
        print("前 500 字预览:")
        print(full_text[:500])
    else:
        print("❌ 解析未能生成任何内容,请检查环境。")
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
运行完成:
- 首次运行警告: 第一次运行时,Docling 会自动从网上下载几个 AI 模型(需要科学上网哦,用于识别表格和版面)。控制台会显示下载进度条,这是正常的,不要关掉终端! 下载一次后,以后运行就是秒级速度。
- 预期输出: 你会看到控制台打印出类似 ## 第一节 重要提示 这样的 Markdown 标题,以及结构整齐的表格。
- 生成文件: 项目根目录下会多出一个 maotai_full_report.md 文件,双击打开就能看到完整的解析结果。
核心知识点总结
- 大文件分块处理(Batch Processing):避免一次性加载庞大文件导致内存溢出,采用“切片-处理-释放”的流水线模式。
- GPU 显存管理:深度学习推理时,显存容易累积。需要手动触发垃圾回收(GC)并清空 GPU 缓存。
- 异常隔离机制:使用 try...except 包裹核心解析逻辑,确保单页解析失败不会导致整个长流程中断。
代码解析
- 导入基础库
import gc
import torch
2
- gc (Garbage Collector):Python 的垃圾回收器,用于手动触发内存清理。
- torch:PyTorch 深度学习框架,这里主要用来调用 CUDA 相关的显存管理接口。
- 导入 Docling 核心组件
from docling.document_converter import DocumentConverter, PdfFormatOption
from docling.datamodel.base_models import InputFormat
from docling.datamodel.pipeline_options import PdfPipelineOptions, AcceleratorOptions, AcceleratorDevice
2
3
- DocumentConverter:Docling 的核心入口类,负责将各种格式(PDF, Word等)转换为统一的文档对象。
- PdfFormatOption:专门用于配置 PDF 解析选项的包装类。
- InputFormat:枚举类,用于指定输入文件的格式(如 InputFormat.PDF)。
- PdfPipelineOptions:配置 PDF 解析流水线的高级选项(如是否开启 OCR 等)。
- AcceleratorOptions & AcceleratorDevice:新版 Docling 用于指定硬件加速的类,用来配置使用 CPU 还是 GPU(CUDA)。
- 定义分批解析函数
def parse_pdf_in_batches(pdf_path):
定义了核心函数,接收一个参数 pdf_path(PDF 文件的路径)。
- 配置解析流水线与硬件
    pipeline_options = PdfPipelineOptions()
    pipeline_options.accelerator_options = AcceleratorOptions(device=AcceleratorDevice.CUDA)

    converter = DocumentConverter(
        format_options={InputFormat.PDF: PdfFormatOption(pipeline_options=pipeline_options)}
    )
2
3
4
5
6
- 实例化 PdfPipelineOptions。
- 配置硬件加速器为 CUDA(NVIDIA 显卡)。
- 初始化 DocumentConverter,通过字典 format_options 将 PDF 格式与对应的 Pipeline 选项绑定。
- 获取 PDF 真实总页数
    try:
        import fitz  # PyMuPDF
        doc = fitz.open(pdf_path)
        total_pages = len(doc)
        doc.close()
        print(f"📄 检测到文档共有 {total_pages} 页,准备分 {batch_size} 页一批进行解析...")
    except ImportError:
        print("⚠️ 未安装 PyMuPDF,无法获取真实页数。建议运行: pip install pymupdf")
        return ""
2
3
4
5
6
7
8
9
- fitz (PyMuPDF):一个极其轻量且高效的 PDF 解析库。这里仅用它来读取总页数,速度极快。
- doc.close():读取完页数后立即关闭文件句柄,释放资源。
- 使用 try...except ImportError 做防御性编程,如果用户没装 PyMuPDF 则给出友好提示并退出。
- 循环分批解析核心逻辑
    all_markdown = []

    for page_num in range(1, total_pages + 1):
        print(f"🚀 正在解析第 {page_num}/{total_pages} 页...")
2
3
4
- all_markdown:创建一个空列表,用来暂存每一页解析出来的 Markdown 文本。
- range(1, total_pages + 1):生成从 1 到总页数的序列(注意:Docling 的页码是从 1 开始的,不是 0)。
- 执行转换与异常隔离
        try:
            result = converter.convert(pdf_path, page_range=(page_num, page_num))
            md_text = result.document.export_to_markdown()

            page_tag = f"\n\n<!-- PAGE: {page_num} -->\n\n"
            all_markdown.append(page_tag + md_text)
2
3
4
5
6
- converter.convert(..., page_range=(page_num, page_num)):这是核心!每次只传入一个包含 2 个相同元素的元组,告诉 Docling 只解析当前这一页。
- export_to_markdown():将内存中的结构化文档对象导出为 Markdown 格式的字符串。
<!-- PAGE: {page_num} -->:利用 HTML 注释语法插入不可见的页码锚点。这在 Markdown 预览时不会显示,但后续 RAG 切片时可以用正则表达式轻松提取,完美实现溯源。
- 强制清理显存与内存(关键)
        gc.collect()
        if torch.cuda.is_available():
            torch.cuda.empty_cache()
2
3
- gc.collect():强制 Python 垃圾回收器运行,释放上一批次产生的无用 Python 对象。
- torch.cuda.is_available():检查当前环境是否有可用的 NVIDIA GPU。
- torch.cuda.empty_cache():核心防崩溃代码。PyTorch 为了效率,默认会缓存已分配的显存。在分批处理大文件时,必须手动调用此方法清空缓存,否则显存会不断累积直到触发 CUDA out of memory 或 std::bad_alloc。
- 合并结果并保存文件
    final_markdown = "\n\n---\n\n".join(all_markdown)
    return final_markdown

if __name__ == "__main__":
    pdf_file = "贵州茅台:贵州茅台2025年年度报告.pdf"
    print("⏳ 开始分批解析,请耐心等待...")
    full_text = parse_pdf_in_batches(pdf_file, batch_size=3)

    if full_text:
        with open("maotai_full_report.md", "w", encoding="utf-8") as f:
            f.write(full_text)
        print("\n🎉 全部解析完成!已保存为 maotai_full_report.md")
        print("前 500 字预览:")
        print(full_text[:500])
    else:
        print("❌ 解析未能生成任何内容,请检查环境。")
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
- "\n\n---\n\n".join():使用 Markdown 的分隔线语法将各批次的文本拼接起来,保持文档结构的清晰。
- with open(...) as f::使用上下文管理器安全地写入文件,指定 encoding="utf-8" 防止中文乱码。
- if name == "main"::Python 的标准入口写法,确保该脚本被直接运行时执行,被其他文件 import 时不执行。
# 数据切片思路
# 1、业务背景痛点
- Docling解析PDF年报后,导出的Markdown全部标题都是
##二级标题,原生#数量无法判定文档层级; - 年报自带页码注释
<!-- PAGE: 数字 -->,需要绑定每一段文本对应的真实页码用于溯源; - 不能硬写正则匹配中文序号(一、(一)、1.1),规则脆弱适配性差;
- 需求:
- 第一层标题永久固定为年报总标题;
- 后续新标题持续叠加,最多保存6层标题路径作为章节面包屑元数据;
- 正文单独拆分出来做向量Embedding,面包屑、页码不参与向量计算,只当作附属元数据;
- 采用两段式切片:先按标题+页码做大块粗分割,再用语义分割做精细化切分。
# 2、技术选型逐项解释
| 依赖/组件 | 作用 | 选择理由 |
|---|---|---|
re 正则库 | 匹配Markdown标题、页面注释标记 | Python内置无需额外安装,轻量高效,专门抓取固定格式标记文本 |
torch | 硬件自动识别CUDA/GPU、CPU | 自动判断电脑有没有NVIDIA显卡,有显卡跑GPU加速Embedding,无显卡自动降级CPU,杜绝直接硬写cuda导致程序崩溃 |
langchain_huggingface.HuggingFaceEmbeddings | 加载BGE-M3向量化模型 | 无缝对接HuggingFace本地模型,适配中英文财报文本 |
BAAI/bge-m3 | 向量嵌入大模型 | 业内通用优质开源双语向量模型,对财报、正式公文语义理解强,输出固定1024维向量,余弦相似度匹配精准,适配检索场景 |
langchain_experimental.SemanticChunker | 语义智能切片器 | 不按固定字符长度切割文本,依靠语义相似度自动判断语句边界,同一段话题内容不会被强行拆断,完美适配财报大段连贯文字 |
tqdm | 进度条 | 可视化查看解析、切片进度,防止程序长时间运行误以为卡死 |
| 原生json | 落地切片结果 | 轻量化结构化存储,直接无缝对接Qdrant向量入库代码 |
# 3、核心切片架构:两段式分层切割(重中之重设计逻辑)
# 阶段1:粗分割(LinearBreadcrumbProcessor)
以标题切换、页码切换作为分割节点:
切割唯一触发条件:识别到全新 Markdown 标题。
物理分页只记录页码,不作为切割边界;同时给每一行正文绑定所属页码、挂载面包屑标题路径。
作用:保证语义大章节不撕裂、跨页内容完整合并、归集全段所有页码。
目的:保证同一个章节、同一页的文本不会被跨页跨章节强行打散,先把大块业务边界划分清楚。
# 阶段2:精细化语义分割(SmartChunker)
对上面产出的每一个粗文本块,基于语义相似度自动切小块; 同一段财务说明、同一段提示文字保留完整,语义断层处自动拆分,产出最终送入向量库的最小语义单元。
# 数据分层设计
content:纯净正文 → 唯一参与Embedding向量化、存入Qdrant向量计算;page、breadcrumb:纯元数据 → 不参与向量计算,检索命中之后再拼接到LLM上下文里给大模型看章节路径。
# 数据切片完整代码
import re
import os
import json
import torch
from typing import List, Dict, Any, Tuple
from tqdm import tqdm
from langchain_experimental.text_splitter import SemanticChunker
from langchain_huggingface import HuggingFaceEmbeddings

# ==========================================
# 1. 配置区
# ==========================================
FILE_PATH = "maotai_full_report.md"
OUTPUT_PATH = "chunked_output.json"
EMBEDDING_MODEL_NAME = "BAAI/bge-m3"
MAX_STACK_DEPTH = 6


# ==========================================
# 行级绑定页码版解析器
# ==========================================
class LinearBreadcrumbProcessor:
    def __init__(self):
        self.title_stack: List[str] = []
        self.root_title: str = ""
        # 全局当前生效页码
        self.active_page: str | None = None

        self.header_pattern = re.compile(r'^(#{1,6})\s+(.*)')
        self.page_pattern = re.compile(r'<!--\s*PAGE:\s*(\d+)\s*-->', re.IGNORECASE)

        # 缓存:(文本内容, 所属页码)
        self.current_paragraph: List[Tuple[str, str]] = []

    def process_markdown(self, content: str) -> List[Dict[str, Any]]:
        lines = content.split('\n')
        processed_chunks = []

        for line in lines:
            stripped_line = line.strip()

            # 命中分页注释,只更新全局生效页码,不切割文本
            page_match = self.page_pattern.search(line)
            if page_match:
                self.active_page = page_match.group(1)
                continue

            # 命中标题,切割当前缓存内容
            header_match = self.header_pattern.match(line)
            if header_match:
                if self.current_paragraph:
                    chunk_data = self._build_chunk()
                    processed_chunks.append(chunk_data)
                    self.current_paragraph.clear()

                raw_title = header_match.group(2).strip()
                raw_title = re.sub(r'<a.*?>.*?</a>', '', raw_title).strip()
                if not raw_title:
                    continue

                if not self.root_title:
                    self.root_title = raw_title
                    self.title_stack.append(raw_title)
                else:
                    self.title_stack.append(raw_title)
                    while len(self.title_stack) > MAX_STACK_DEPTH:
                        self.title_stack.pop(1)
                continue

            # 普通有效正文行,绑定当前生效页码存入缓存
            if stripped_line and self.active_page is not None:
                self.current_paragraph.append((stripped_line, self.active_page))
            elif stripped_line and self.active_page is None:
                # 还没读到任何页码,暂时标记待定
                self.current_paragraph.append((stripped_line, None))

        # 收尾剩余文本
        if self.current_paragraph:
            processed_chunks.append(self._build_chunk())

        return processed_chunks

    def _build_chunk(self) -> Dict[str, Any]:
        # 拼接完整文本
        full_text_parts = [text for text, _ in self.current_paragraph]
        pure_body = " ".join(full_text_parts)
        full_breadcrumb = " > ".join(self.title_stack)

        # 提取本段所有正文绑定的页码,去重排序
        page_collect = set()
        for _, page in self.current_paragraph:
            if page is not None:
                page_collect.add(page)

        page_list = sorted(list(page_collect))
        if not page_list:
            page_list = ["未知"]

        return {
            "pure_text": pure_body,
            "meta_page": page_list,
            "meta_breadcrumb": full_breadcrumb,
        }


class SmartChunker:
    def __init__(self, model_name: str):
        device = "cuda" if torch.cuda.is_available() else "cpu"
        print(f"检测运行设备:{device},加载Embedding模型 {model_name}")

        self.embeddings = HuggingFaceEmbeddings(
            model_name=model_name,
            model_kwargs={"device": device}
        )
        self.splitter = SemanticChunker(
            self.embeddings,
            breakpoint_threshold_type="percentile",
            breakpoint_threshold_amount=95
        )

    def chunk_text(self, data_list: List[Dict[str, Any]]) -> List[Dict[str, Any]]:
        all_results = []
        for i, item in enumerate(tqdm(data_list, desc="语义切分")):
            source_text = item["pure_text"]
            page_info = item["meta_page"]
            breadcrumb_info = item["meta_breadcrumb"]

            sub_chunks = self.splitter.split_text(source_text)
            for j, seg in enumerate(sub_chunks):
                seg_clean = seg.strip()
                if not seg_clean:
                    continue
                all_results.append({
                    "id": f"doc_chunk_{i}_{j}",
                    "content": seg_clean,
                    "page": page_info,
                    "breadcrumb": breadcrumb_info,
                    "source_index": i
                })
        return all_results


def main():
    if not os.path.exists(FILE_PATH):
        print(f"文件不存在:{FILE_PATH}")
        return

    with open(FILE_PATH, "r", encoding="utf-8") as f:
        md_content = f.read()

    processor = LinearBreadcrumbProcessor()
    coarse_chunks = processor.process_markdown(md_content)
    print(f"粗分块数量:{len(coarse_chunks)}")

    chunker = SmartChunker(EMBEDDING_MODEL_NAME)
    final_chunks = chunker.chunk_text(coarse_chunks)
    print(f"最终语义切片总数:{len(final_chunks)}")

    with open(OUTPUT_PATH, "w", encoding="utf-8") as f:
        json.dump(final_chunks, f, ensure_ascii=False, indent=2)

    print(f"输出路径:{os.path.abspath(OUTPUT_PATH)}")
    if final_chunks:
        print("\n样例数据:")
        print(json.dumps(final_chunks[0], ensure_ascii=False, indent=2))


if __name__ == "__main__":
    main()
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
145
146
147
148
149
150
151
152
153
154
155
156
157
158
159
160
161
162
163
164
165
166
167
168
169
170
# 头部导入代码逐行解释
import re
import os
import json
import torch
from typing import List, Dict, Any, Tuple
from tqdm import tqdm
from langchain_experimental.text_splitter import SemanticChunker
from langchain_huggingface import HuggingFaceEmbeddings
2
3
4
5
6
7
8
import re:正则表达式库,用来精准匹配两种规则:^(#{1,6})\s+(.*):行开头1~6个#号的Markdown标题;<!--\s*PAGE:\s*(\d+)\s*-->:匹配注释里的分页页码数字。
os:文件系统操作,判断本地maotai_full_report.md文件是否存在。json:把最终切好的结构化切片写入chunked_output.json。torch:检测当前环境有没有可用NVIDIA GPU,优先把Embedding模型放到GPU加速推理,没有则自动切CPU。typing:类型提示:List:列表;Dict:字典;Tuple:元组;Any:任意类型数据;- 比如
List[Tuple[str, str]]:列表内部每一项是(文本字符串,页码字符串)二元组。
tqdm:包裹循环生成控制台动态进度条,跑大数据量时直观看到切分进度。SemanticChunker:Langchain实验性语义切分器,核心逻辑:把文本分句向量化,相邻句子向量差距超过阈值就判定为语义割裂,在这里切一刀。HuggingFaceEmbeddings:对接HuggingFace模型仓库,自动下载、加载BGE-M3本地Embedding模型。
# 配置区逐行解读
# ==========================================
# 1. 配置区
# ==========================================
FILE_PATH = "maotai_full_report.md"
OUTPUT_PATH = "chunked_output.json"
EMBEDDING_MODEL_NAME = "BAAI/bge-m3"
MAX_STACK_DEPTH = 6
2
3
4
5
6
7
FILE_PATH:待解析的源文件路径,PDF转出来的财报Markdown文件。OUTPUT_PATH:最终切分完成后的结构化数据输出JSON路径。EMBEDDING_MODEL_NAME:指定语义切分所使用的向量模型,BGE-M3适配中文财报、正式文书。MAX_STACK_DEPTH = 6:标题栈最大深度,面包屑路径最多保存6级层级标题;超过6级时删掉最早入栈的顶层标题,防止面包屑路径过长冗余。
# 核心类一:LinearBreadcrumbProcessor 保姆级逐行拆解
# 类整体定位
第一级粗解析器,三大核心职责: ① 逐行扫描MD全文,仅新标题触发文本切割,分页只记录不切割; ② 每一行正文绑定当前生效页码,最终归集整块文本所有跨页页码; ③ 维护标题栈,生成层级面包屑路径; ④ 输出规整的粗分块,携带完整文本、页码数组、面包屑。
# __init__ 构造初始化逐行解析
def __init__(self):
    self.title_stack: List[str] = []
    self.root_title: str = ""
    # 全局当前生效页码
    self.active_page: str | None = None

    self.header_pattern = re.compile(r'^(#{1,6})\s+(.*)')
    self.page_pattern = re.compile(r'<!--\s*PAGE:\s*(\d+)\s*-->', re.IGNORECASE)

    # 缓存:(文本内容, 所属页码)
    self.current_paragraph: List[Tuple[str, str]] = []
2
3
4
5
6
7
8
9
10
11
逐个变量拆解:
self.title_stack: List[str] = []标题栈,栈结构,后进先出,用来记录当前所处的各级标题。 示例:先读到# 年报总览入栈,再读到## 财务数据入栈,面包屑就是年报总览 > 财务数据。self.root_title: str = ""标记整篇文档第一个出现的一级主标题,固定为面包屑最顶层根节点,永久常驻栈底。self.active_page: str | None = None全局实时生效页码: 一旦扫描到<!-- PAGE:10 -->,这个变量立刻赋值为"10";后续所有正文行都会绑定这个页码,直到下一个分页标记更新它。 初始None:代表还没读取到任何分页注释。self.header_pattern标题正则解析^(#{1,6})\s+(.*)^:匹配一行的开头,确保是真正行首的Markdown标题,排除正文里夹杂的#号;#{1,6}:匹配16个#,对应H1H6六级标题;\s+:#号后面的空格;(.*):捕获标题后面的文字内容。
self.page_pattern分页注释正则<!--\s*PAGE:\s*(\d+)\s*-->,re.IGNORECASE忽略大小写(page/PAGE都能识别):- 精准抓取注释内部的数字页码,
(\d+)捕获分组拿到纯数字。
- 精准抓取注释内部的数字页码,
self.current_paragraph: List[Tuple[str, str]] = []当前正在收集的正文缓冲区,元组格式:(单行正文文本, 这一行所属的页码)。 这是解决跨页页码收集不准的核心设计:每一行正文从写入那一刻就钉死归属页码,后续打包汇总时直接遍历全部行的页码,天然集齐所有跨页页码。
# 核心主流程:process_markdown 逐行遍历全文
def process_markdown(self, content: str) -> List[Dict[str, Any]]:
    lines = content.split('\n')
    processed_chunks = []

    for line in lines:
        stripped_line = line.strip()
2
3
4
5
6
content.split('\n'):把整个MD文本按换行符切割成一行一行,逐行循环处理;processed_chunks = []:存放最终粗切分完成的所有大块文本结果;stripped_line = line.strip():去除当前行首尾空白、换行、空格,空行直接后续过滤丢弃。
# 分支1:命中分页注释行
        # 命中分页注释,只更新全局生效页码,不切割文本
        page_match = self.page_pattern.search(line)
        if page_match:
            self.active_page = page_match.group(1)
            continue
2
3
4
5
执行逻辑:
- 用正则在当前行查找分页注释;
- 如果匹配成功,提取页码数字赋值给全局
self.active_page; continue直接跳过当前行后续逻辑,不会清空正文缓冲区、不会切割文本。 关键保障:分页只改当前生效页码,已经收集的正文继续往后拼接,跨页表格、文字不会被强行斩断。
# 分支2:命中Markdown标题行(唯一切割触发点)
        # 命中标题,切割当前缓存内容
        header_match = self.header_pattern.match(line)
        if header_match:
            if self.current_paragraph:
                chunk_data = self._build_chunk()
                processed_chunks.append(chunk_data)
                self.current_paragraph.clear()

            raw_title = header_match.group(2).strip()
            raw_title = re.sub(r'<a.*?>.*?</a>', '', raw_title).strip()
            if not raw_title:
                continue

            if not self.root_title:
                self.root_title = raw_title
                self.title_stack.append(raw_title)
            else:
                self.title_stack.append(raw_title)
                while len(self.title_stack) > MAX_STACK_DEPTH:
                    self.title_stack.pop(1)
            continue
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
分步拆解:
header_match.match(line):必须是行开头的标题;- 前置判断:如果缓冲区
current_paragraph里还有没打包的正文:- 调用
_build_chunk()把当前积攒的所有正文打包成一条粗分块; - 加入结果列表;
clear()清空缓冲区,准备收集新标题下的正文。
- 调用
- 提取标题文字:
header_match.group(2)拿到标题原文; re.sub(r'<a.*?>.*?</a>', '', raw_title):正则清除标题里多余的HTML链接<a>xxx</a>标签,清洗脏数据;- 如果清洗后标题为空,直接跳过不处理;
- 标题入栈逻辑:
self.root_title为空:说明是全文第一个顶层标题,标记为根标题并入栈;- 非首个标题:直接追加进标题栈;
- 循环判断栈长度,如果超过配置的
MAX_STACK_DEPTH=6,执行pop(1)删除下标1的元素(下标0是根标题永久不动),保证栈最多6层。 continue跳过本行后续逻辑,本行只是标题,不进入正文收集。
# 分支3:普通正文行,存入缓冲区并绑定页码
            # 普通有效正文行,绑定当前生效页码存入缓存
            if stripped_line and self.active_page is not None:
                self.current_paragraph.append((stripped_line, self.active_page))
            elif stripped_line and self.active_page is None:
                # 还没读到任何页码,暂时标记待定
                self.current_paragraph.append((stripped_line, None))
2
3
4
5
6
stripped_line不为空:判定为有效正文行;- 场景A:
self.active_page已有有效页码 → 存入元组(文本, 当前页码); - 场景B:还没读取到任何分页注释,
active_page=None→ 存入(文本, None),代表该行暂时无绑定页码; 这部分行后续打包时不会纳入页码集合,只会用兜底逻辑填充。
# 循环结束,处理文档末尾剩余未打包正文
        # 收尾剩余文本
        if self.current_paragraph:
            processed_chunks.append(self._build_chunk())

        return processed_chunks
2
3
4
5
文档遍历全部结束后,缓冲区里大概率还有最后一个章节的正文没有遇到下一个标题触发打包,手动执行一次打包,避免尾部文本丢失。
# 内部打包函数 _build_chunk 逐行解析
作用:把缓冲区里积攒的带页码标记的所有正文,拼接完整文本、归集全部页码、生成面包屑路径,输出结构化粗分字典。
    def _build_chunk(self) -> Dict[str, Any]:
        # 拼接完整文本
        full_text_parts = [text for text, _ in self.current_paragraph]
        pure_body = " ".join(full_text_parts)
        full_breadcrumb = " > ".join(self.title_stack)

        # 提取本段所有正文绑定的页码,去重排序
        page_collect = set()
        for _, page in self.current_paragraph:
            if page is not None:
                page_collect.add(page)

        page_list = sorted(list(page_collect))
        if not page_list:
            page_list = ["未知"]

        return {
            "pure_text": pure_body,
            "meta_page": page_list,
            "meta_breadcrumb": full_breadcrumb,
        }
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
[text for text, _ in self.current_paragraph]列表推导式:只提取元组里的文本部分,丢掉临时绑定的页码,用空格拼接成一整段连贯文本;" > ".join(self.title_stack):把标题栈列表拼接成路径式面包屑,示例["年报","财务摘要","营收分析"]→年报 > 财务摘要 > 营收分析;- 归集页码核心逻辑:
- 初始化空集合
page_collect(集合自带自动去重,同一个页码多次出现只会存一份); - 遍历缓冲区所有元组,只要页码不为
None就加入集合; sorted(list(page_collect))转成有序列表,从小到大排序页码;- 集合为空(本段所有正文都没绑定有效页码),兜底赋值
["未知"];
- 初始化空集合
- 返回结构化字典三个字段:
pure_text:拼接好的完整章节文本;meta_page:数组,单页["10"]、跨页["10","11"];meta_breadcrumb:当前文本所属的标题层级路径。
# 第二级切片:SmartChunker 语义精细化切分解析
# 类定位
接收上面输出的大块粗文本,基于语义相似度智能拆分小块,适配向量数据库入库,不会把一句话、一张完整表格强行拆碎。
class SmartChunker:
    def __init__(self, model_name: str):
        device = "cuda" if torch.cuda.is_available() else "cpu"
        print(f"检测运行设备:{device},加载Embedding模型 {model_name}")

        self.embeddings = HuggingFaceEmbeddings(
            model_name=model_name,
            model_kwargs={"device": device}
        )
        self.splitter = SemanticChunker(
            self.embeddings,
            breakpoint_threshold_type="percentile",
            breakpoint_threshold_amount=95
        )
2
3
4
5
6
7
8
9
10
11
12
13
14
device = "cuda" if torch.cuda.is_available() else "cpu":自动硬件判断,有GPU用GPU加速向量计算,没有则CPU运行;HuggingFaceEmbeddings加载BGE-M3模型,指定模型运行设备;SemanticChunker关键参数解读:breakpoint_threshold_type="percentile":百分位阈值判定法;breakpoint_threshold_amount=95:95百分位规则: 计算相邻两句文本向量之间的余弦距离,把所有距离从小到大排序,只有距离超过95%分位值时,才判定两句语义差距极大,在这里切开。 95这个数值偏保守,大部分关联紧密的同主题文字、整张表格都会保留为一整块,只有完全换话题才切分。
# 核心切分方法 chunk_text
    def chunk_text(self, data_list: List[Dict[str, Any]]) -> List[Dict[str, Any]]:
        all_results = []
        for i, item in enumerate(tqdm(data_list, desc="语义切分")):
            source_text = item["pure_text"]
            page_info = item["meta_page"]
            breadcrumb_info = item["meta_breadcrumb"]

            sub_chunks = self.splitter.split_text(source_text)
            for j, seg in enumerate(sub_chunks):
                seg_clean = seg.strip()
                if not seg_clean:
                    continue
                all_results.append({
                    "id": f"doc_chunk_{i}_{j}",
                    "content": seg_clean,
                    "page": page_info,
                    "breadcrumb": breadcrumb_info,
                    "source_index": i
                })
        return all_results
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
- 外层循环遍历每一条粗分块,
tqdm展示语义切分进度; - 取出粗块的完整文本、对应的页码数组、面包屑;
self.splitter.split_text(source_text):语义模型自动切分成若干个语义独立的小片段;- 内层循环遍历每一个语义切片,剔除空白切片;
- 组装最终入库标准字段:
id:唯一标识,doc_chunk_粗块下标_语义切片下标;content:最终入库的纯文本;page:继承父级粗块的页码数组(一个语义切片属于父级的全部跨页);breadcrumb:继承所属章节的标题路径;source_index:记录来源于第几个粗分块,方便溯源调试。
# main主函数整体调度流程
def main():
    if not os.path.exists(FILE_PATH):
        print(f"文件不存在:{FILE_PATH}")
        return

    with open(FILE_PATH, "r", encoding="utf-8") as f:
        md_content = f.read()

    processor = LinearBreadcrumbProcessor()
    coarse_chunks = processor.process_markdown(md_content)
    print(f"粗分块数量:{len(coarse_chunks)}")

    chunker = SmartChunker(EMBEDDING_MODEL_NAME)
    final_chunks = chunker.chunk_text(coarse_chunks)
    print(f"最终语义切片总数:{len(final_chunks)}")

    with open(OUTPUT_PATH, "w", encoding="utf-8") as f:
        json.dump(final_chunks, f, ensure_ascii=False, indent=2)

    print(f"输出路径:{os.path.abspath(OUTPUT_PATH)}")
    if final_chunks:
        print("\n样例数据:")
        print(json.dumps(final_chunks[0], ensure_ascii=False, indent=2))
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
完整执行顺序:
- 文件合法性校验,如果md文件不存在直接退出;
- 以utf-8编码读取整个Markdown全文;
- 实例化粗解析器,执行第一级按标题粗切分;
- 实例化语义切分器,对粗块二次精细化语义切分;
- 将最终结构化切片写入本地JSON文件;
- 控制台打印统计数量、文件绝对路径,输出第一条切片样例用于查看格式是否正常。
# 整体切片实际运行效果演示
# 测试样例MD输入
# 年度财务报告
## 营业收入明细
<!-- PAGE:20 -->
本期主营业务营业收入合计120亿元,毛利率45%
<!-- PAGE:21 -->
下表为各产品线营收构成:
|产品线|营收|占比|
|白酒|100亿|83%|
|系列酒|20亿|17%|
## 下一个大章节
其他无关正文
2
3
4
5
6
7
8
9
10
11
# 步骤1:粗切分结果
只在## 下一个大章节触发切割,前面跨20、21页的文字+整张表格合并为单个粗分块:
{
    "pure_text": "本期主营业务营业收入合计120亿元,毛利率45% 下表为各产品线营收构成: |产品线|营收|占比| |白酒|100亿|83%| |系列酒|20亿|17%|",
    "meta_page": ["20","21"],
    "meta_breadcrumb": "年度财务报告 > 营业收入明细"
}
2
3
4
5
完美归集两页页码,表格没有被分页打断。
# 步骤2:语义二次切分效果
因为整段都是营收相关同一语义,语义切分器不会拆分,最终输出一条切片:
{
    "id": "doc_chunk_0_0",
    "content": "本期主营业务营业收入合计120亿元,毛利率45% 下表为各产品线营收构成: |产品线|营收|占比| |白酒|100亿|83%| |系列酒|20亿|17%|",
    "page": ["20","21"],
    "breadcrumb": "年度财务报告 > 营业收入明细",
    "source_index": 0
}
2
3
4
5
6
7
# 里程碑 3:构建向量索引(Qdrant)
目标:让系统具备“模糊语义搜索”的能力。
你需要完成:
- 编写 vector_indexer.py。
- 选择一个 Embedding 模型(推荐开源免费的 BGE-M3,或者直接用 OpenAI 的 API)。
- 将里程碑 2 切分好的文本块转化为向量,批量写入 Qdrant。
- 验证:写一段测试代码,输入一个问题(比如“去年的净利润是多少”),看看 Qdrant 能不能返回最相关的那段文本。
# 零基础前置核心概念
# 1.1 我们现在要做什么(项目目标)
前面里程碑:PDF解析→文本切片chunked_output.json
本里程碑:
文本片段 → Embedding模型转为数字向量 → 存入Qdrant向量数据库
后续提问时:问题同样转向量,在库中匹配语义最相近的文本,实现语义检索,不是简单关键词匹配。
# 关键名词通俗解释
Embedding嵌入模型(BGE-M3) 一句话:把人类文字转换成一串固定长度数字(向量),语义相近的文字,数字向量距离更近。 例:
今年分红方案、年度利润分配计划字面文字不一样,语义一致,向量会靠在一起。向量数据库Qdrant 普通MySQL只擅长关键词精确匹配; Qdrant专门存储海量向量,内置高效算法快速计算向量相似度,一秒找出最相似文本。
余弦相似度
COSINE衡量两个向量之间语义相似度,数值区间[-1,1],越接近1代表语义越相似。PointStruct Qdrant里最小存储单元:一条向量 + 附带的业务元数据(原文、页码、章节路径等)。
# 本项目用到全部工具栈
| 工具 | 作用 |
|---|---|
| Python | 主编程语言 |
| PyTorch | GPU加速运行BGE-M3大模型推理 |
| langchain_huggingface | 封装BGE-M3,简化文本向量化调用 |
| Qdrant | 高性能本地向量数据库 |
| tqdm | 命令行可视化进度条 |
| json | 读取你上一步切分好的文本分片文件 |
# 核心API详细介绍
# langchain_huggingface.HuggingFaceEmbeddings
封装SentenceTransformer模型,提供两个核心接口:
embed_query(单段文本):把单个问句转为向量,用于检索阶段;embed_documents(文本列表):批量多条文本向量化,入库阶段使用。
关键入参:
model_name:模型地址BAAI/bge-m3,首次运行自动下载到本地缓存;model_kwargs:硬件配置(使用cuda/gpu、精度设置);encode_kwargs:推理配置,单次GPU处理条数、向量归一化。
# Qdrant Client核心API
QdrantClient(host,port):建立和本地Qdrant服务的TCP连接;collection_exists(name):判断向量集合是否存在;delete_collection(name):清空整个向量库;create_collection():创建向量容器,指定向量维度、相似度算法;upsert(points):批量写入向量数据;query_points():传入问题向量,召回库内相似度最高的向量数据。
# Qdrant关键数据结构
VectorParams配置向量基础属性:size=1024:BGE-M3输出向量固定长度1024维数字;distance=Distance.COSINE:使用余弦计算相似度。PointStruct单条存储单元:id:唯一编号;vector:embedding向量;payload:自定义附带元数据(原文、页码、章节路径)。
# 整份代码分段+逐行保姆式拆解
# 完整代码
import json
import os
import torch
from typing import List, Dict, Any
from tqdm import tqdm

# 1. 导入 Qdrant 客户端和数据结构
from qdrant_client import QdrantClient
from qdrant_client.models import Distance, VectorParams, PointStruct

# 新版Embedding导入,解决弃用警告
from langchain_huggingface import HuggingFaceEmbeddings

# ==========================================
# 配置区
# ==========================================
INPUT_JSON = "chunked_output.json"
COLLECTION_NAME = "maotai_report_v1"
EMBEDDING_MODEL_NAME = "BAAI/bge-m3"
QDRANT_HOST = "localhost"
QDRANT_PORT = 6333

# 调参:根据你的显卡显存自行修改
# 8G显存推荐 8~16;16G显存 16~32;越大越快
EMBED_BATCH_SIZE = 16
# Qdrant单次网络写入批次
UPSERT_BATCH_SIZE = 32


# ==========================================
# 向量索引构建器
# ==========================================
class VectorIndexBuilder:
    def __init__(self, collection_name: str, model_name: str):
        self.collection_name = collection_name

        # 自动判定运行设备
        device = "cuda" if torch.cuda.is_available() else "cpu"
        print(f"🧠 检测设备:{device},正在加载 Embedding 模型: {model_name} ...")

        # 全局关闭梯度计算,推理专用,省显存提速
        torch.set_grad_enabled(False)

        # 修复点:torch_dtype 放到 model_kwargs 的 model_kwargs 内层,传给底层AutoModel
        self.embeddings = HuggingFaceEmbeddings(
            model_name=model_name,
            model_kwargs={
                'device': device,
                # 内层嵌套,交给transformers.AutoModel加载时指定精度
                "model_kwargs": {
                    "torch_dtype": torch.float16
                }
            },
            encode_kwargs={
                "batch_size": EMBED_BATCH_SIZE,
                "normalize_embeddings": True
            }
        )

        # 连接Qdrant
        print(f"🔗 正在连接 Qdrant: {QDRANT_HOST}:{QDRANT_PORT} ...")
        self.client = QdrantClient(host=QDRANT_HOST, port=QDRANT_PORT)

    def create_collection(self, vector_dim: int):
        if self.client.collection_exists(self.collection_name):
            print(f"⚠️ 集合 '{self.collection_name}' 已存在,删除重建...")
            self.client.delete_collection(self.collection_name)

        print(f"🏗️ 创建集合,向量维度: {vector_dim}")
        self.client.create_collection(
            collection_name=self.collection_name,
            vectors_config=VectorParams(
                size=vector_dim,
                distance=Distance.COSINE
            )
        )
        print("✅ 集合创建完成")

    def build_index(self, data_path: str):
        if not os.path.exists(data_path):
            raise FileNotFoundError(f"❌ 文件不存在:{data_path}")

        with open(data_path, 'r', encoding='utf-8') as f:
            chunks: List[Dict[str, Any]] = json.load(f)

        print(f"📚 原始加载 {len(chunks)} 个文本块")

        # 第一步:过滤空文本,整理好全部待处理数据
        all_data = []
        for idx, chunk in enumerate(tqdm(chunks, desc="预处理过滤有效文本")):
            content = chunk.get("content", "").strip()
            if not content:
                continue
            meta = {
                "content": content,
                "page": chunk.get("page", "未知"),
                "breadcrumb": chunk.get("breadcrumb", ""),
                "source_index": chunk.get("source_index", -1)
            }
            all_data.append({"id": idx, "text": content, "meta": meta})

        total_count = len(all_data)
        if total_count == 0:
            print("❌ 无有效文本数据,终止入库")
            return
        print(f"✅ 过滤后有效文本总数:{total_count}")

        # 探测向量维度
        test_vec = self.embeddings.embed_query("test")
        self.create_collection(len(test_vec))

        # 第二步:带进度条分批向量化 + 分批写入Qdrant
        print("\n⚡ 开始分批向量化并入库...")
        qdrant_points_buffer: List[PointStruct] = []

        # 外层进度条:整体处理进度
        pbar_total = tqdm(range(0, total_count, EMBED_BATCH_SIZE), desc="向量化+入库总进度")

        for start in pbar_total:
            end = start + EMBED_BATCH_SIZE
            batch_slice = all_data[start:end]

            batch_texts = [item["text"] for item in batch_slice]
            batch_ids = [item["id"] for item in batch_slice]
            batch_metas = [item["meta"] for item in batch_slice]

            # 当前小批量向量化
            batch_vecs = self.embeddings.embed_documents(batch_texts)

            # 组装PointStruct放入写入缓冲区
            for pid, vec, meta in zip(batch_ids, batch_vecs, batch_metas):
                qdrant_points_buffer.append(
                    PointStruct(
                        id=pid,
                        vector=vec,
                        payload=meta
                    )
                )

                # 缓冲区达到阈值就写入Qdrant
                if len(qdrant_points_buffer) >= UPSERT_BATCH_SIZE:
                    self.client.upsert(
                        collection_name=self.collection_name,
                        points=qdrant_points_buffer
                    )
                    # 更新进度条后置提示
                    pbar_total.set_postfix({
                        "已入库": f"{start + len(qdrant_points_buffer)} / {total_count}"
                    })
                    qdrant_points_buffer.clear()

        # 循环结束,写入缓冲区剩余数据
        if qdrant_points_buffer:
            self.client.upsert(collection_name=self.collection_name, points=qdrant_points_buffer)

        print(f"\n🎉 全部入库完成,成功写入 {total_count} 条向量数据")

    def search(self, query: str, top_k: int = 3):
        print(f"\n🔍 检索问题:{query}")
        query_vec = self.embeddings.embed_query(query)

        results = self.client.query_points(
            collection_name=self.collection_name,
            query=query_vec,
            limit=top_k
        )

        hits = results.points
        print(f"✅ 检索到 {len(hits)} 条结果\n")
        for rank, hit in enumerate(hits, 1):
            score = hit.score
            payload = hit.payload
            page = payload["page"]
            breadcrumb = payload["breadcrumb"]
            content = payload["content"]

            print(f"===== 第{rank}名 | 相似度:{score:.4f} =====")
            print(f"📍 页码:{page} | 章节路径:{breadcrumb}")
            print(f"📖 正文片段:{content[:300]}...\n")


# ==========================================
# 主入口
# ==========================================
def main():
    builder = VectorIndexBuilder(COLLECTION_NAME, EMBEDDING_MODEL_NAME)

    # 先放开注释执行入库,入库完成后注释掉,只跑检索测试
    builder.build_index(INPUT_JSON)

    # 年报适配测试问句,验收检索效果
    test_query = "2025年度利润分配分红方案是什么?"
    builder.search(test_query, top_k=3)


if __name__ == "__main__":
    main()
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
145
146
147
148
149
150
151
152
153
154
155
156
157
158
159
160
161
162
163
164
165
166
167
168
169
170
171
172
173
174
175
176
177
178
179
180
181
182
183
184
185
186
187
188
189
190
191
192
193
194
195
196
197
198
# 第一部分:顶部导包区域
import json
import os
import torch
from typing import List, Dict, Any
from tqdm import tqdm

# Qdrant相关导入
from qdrant_client import QdrantClient
from qdrant_client.models import Distance, VectorParams, PointStruct

# Langchain封装的HuggingFace向量化工具
from langchain_huggingface import HuggingFaceEmbeddings
2
3
4
5
6
7
8
9
10
11
12
json:读取上一步生成的chunked_output.json文本分片文件;os:判断文件是否存在,防止路径错误;torch:GPU调度、模型精度设置、关闭训练梯度;typing类型注解:标注变量是列表、字典,规范代码,方便阅读;tqdm:命令行动态进度条;QdrantClient:连接本地向量数据库的客户端;Distance:相似度计算方式枚举(余弦、欧式距离等);VectorParams:创建集合时向量参数配置;PointStruct:Qdrant单条数据封装体;HuggingFaceEmbeddings:加载BGE-M3模型做文本向量化。
# 第二部分:全局配置区
INPUT_JSON = "chunked_output.json"
COLLECTION_NAME = "maotai_report_v1"
EMBEDDING_MODEL_NAME = "BAAI/bge-m3"
QDRANT_HOST = "localhost"
QDRANT_PORT = 6333

EMBED_BATCH_SIZE = 16
UPSERT_BATCH_SIZE = 32
2
3
4
5
6
7
8
INPUT_JSON:待入库的切片文本文件路径;COLLECTION_NAME:Qdrant里面向量集合名称,相当于数据库里的一张表;EMBEDDING_MODEL_NAME:选用的向量化模型;QDRANT_HOST/PORT:本地Qdrant地址端口,固定默认6333;EMBED_BATCH_SIZE=16:每次丢16条文本进GPU计算向量,显存小就改成8、4;UPSERT_BATCH_SIZE=32:攒够32条向量一次性发给Qdrant写入,减少网络频繁请求。
# 第三部分:主类 VectorIndexBuilder 向量构建器
# 3.1 __init__构造方法:初始化模型+连接数据库
def __init__(self, collection_name: str, model_name: str):
    self.collection_name = collection_name

    # 自动判定运行设备
    device = "cuda" if torch.cuda.is_available() else "cpu"
    print(f"🧠 检测设备:{device},正在加载 Embedding 模型: {model_name} ...")

    # 全局关闭梯度计算,推理专用,省显存提速
    torch.set_grad_enabled(False)

    # 初始化BGE-M3向量化模型
    self.embeddings = HuggingFaceEmbeddings(
        model_name=model_name,
        model_kwargs={
            'device': device,
            "model_kwargs": {
                "torch_dtype": torch.float16
            }
        },
        encode_kwargs={
            "batch_size": EMBED_BATCH_SIZE,
            "normalize_embeddings": True
        }
    )

    # 连接Qdrant
    print(f"🔗 正在连接 Qdrant: {QDRANT_HOST}:{QDRANT_PORT} ...")
    self.client = QdrantClient(host=QDRANT_HOST, port=QDRANT_PORT)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
逐段拆解:
self.collection_name:把集合名绑定到实例全局;device = cuda if torch.cuda.is_available(): 判断你的电脑有没有N卡GPU,有就用GPU加速推理,没有自动降级CPU运行;torch.set_grad_enabled(False): 模型是推理使用,不需要训练更新权重,关闭梯度计算,直接节约大量显存;model_kwargs详解:device:指定模型加载到GPU/CPU;- 内层
torch.float16:半精度加载模型,显存占用直接减半,GPU运行必备优化;
encode_kwargs:batch_size:单次GPU并行处理文本数量;normalize_embeddings=True:向量归一化,余弦相似度计算结果更稳定;
QdrantClient(...):建立本地Socket连接,后续所有增删改查都依靠这个self.client对象。
# 3.2 create_collection:创建/重置向量集合
def create_collection(self, vector_dim: int):
    if self.client.collection_exists(self.collection_name):
        print(f"⚠️ 集合 '{self.collection_name}' 已存在,删除重建...")
        self.client.delete_collection(self.collection_name)

    print(f"🏗️ 创建集合,向量维度: {vector_dim}")
    self.client.create_collection(
        collection_name=self.collection_name,
        vectors_config=VectorParams(
            size=vector_dim,
            distance=Distance.COSINE
        )
    )
    print("✅ 集合创建完成")
2
3
4
5
6
7
8
9
10
11
12
13
14
逻辑:
- 判断集合是否已经存在,存在就直接删除旧数据,避免新旧向量混杂;
vector_dim:向量长度,由BGE-M3测试向量自动获取(固定1024);VectorParams配置:向量长度1024,采用余弦相似度匹配;create_collection在Qdrant里开辟一块专门存储该批次向量的空间。
# 3.3 build_index 核心主逻辑:加载文本→向量化→分批入库
- 阶段1:读取JSON并清洗有效文本
def build_index(self, data_path: str):
    if not os.path.exists(data_path):
        raise FileNotFoundError(f"❌ 文件不存在:{data_path}")

    with open(data_path, 'r', encoding='utf-8') as f:
        chunks: List[Dict[str, Any]] = json.load(f)

    print(f"📚 原始加载 {len(chunks)} 个文本块")

    # 第一步:过滤空文本,整理好全部待处理数据
    all_data = []
    for idx, chunk in enumerate(tqdm(chunks, desc="预处理过滤有效文本")):
        content = chunk.get("content", "").strip()
        if not content:
            continue
        meta = {
            "content": content,
            "page": chunk.get("page", "未知"),
            "breadcrumb": chunk.get("breadcrumb", ""),
            "source_index": chunk.get("source_index", -1)
        }
        all_data.append({"id": idx, "text": content, "meta": meta})

    total_count = len(all_data)
    if total_count == 0:
        print("❌ 无有效文本数据,终止入库")
        return
    print(f"✅ 过滤后有效文本总数:{total_count}")
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
逐行解读:
- 判断json文件是否存在,不存在抛出异常;
json.load()读取切片后的全部文本数组;- 循环遍历每一条切片,
tqdm展示预处理进度条; content.strip()去除首尾空格,空文本直接丢弃,无效数据不入库;meta打包元数据:原文内容、页码、章节路径、原始序号;- 把id、文本、元数据统一存入
all_data列表,统一管理。
- 阶段2:探测向量维度 + 初始化Qdrant集合
# 探测向量维度
test_vec = self.embeddings.embed_query("test")
self.create_collection(len(test_vec))
2
3
随便输入一句测试文本,生成一条向量,拿到向量长度1024;
调用上面的
create_collection创建对应维度的向量集合。阶段3:分批向量化+攒批写入Qdrant(带进度条核心逻辑)
print("\n⚡ 开始分批向量化并入库...")
qdrant_points_buffer: List[PointStruct] = []

# 外层进度条:整体处理进度
pbar_total = tqdm(range(0, total_count, EMBED_BATCH_SIZE), desc="向量化+入库总进度")

for start in pbar_total:
    end = start + EMBED_BATCH_SIZE
    batch_slice = all_data[start:end]

    batch_texts = [item["text"] for item in batch_slice]
    batch_ids = [item["id"] for item in batch_slice]
    batch_metas = [item["meta"] for item in batch_slice]

    # 当前小批量向量化
    batch_vecs = self.embeddings.embed_documents(batch_texts)

    # 组装PointStruct放入写入缓冲区
    for pid, vec, meta in zip(batch_ids, batch_vecs, batch_metas):
        qdrant_points_buffer.append(
            PointStruct(
                id=pid,
                vector=vec,
                payload=meta
            )
        )

        # 缓冲区达到阈值就写入Qdrant
        if len(qdrant_points_buffer) >= UPSERT_BATCH_SIZE:
            self.client.upsert(
                collection_name=self.collection_name,
                points=qdrant_points_buffer
            )
            # 更新进度条后置提示
            pbar_total.set_postfix({
                "已入库": f"{start + len(qdrant_points_buffer)} / {total_count}"
            })
            qdrant_points_buffer.clear()

# 循环结束,写入缓冲区剩余数据
if qdrant_points_buffer:
    self.client.upsert(collection_name=self.collection_name, points=qdrant_points_buffer)

print(f"\n🎉 全部入库完成,成功写入 {total_count} 条向量数据")
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
核心逻辑拆解:
qdrant_points_buffer:临时缓冲区,攒够设定条数再一次性写入数据库,避免频繁IO;tqdm(range(0, total_count, EMBED_BATCH_SIZE)):按设定步长分批循环,展示全局总进度条;- 截取当前批次文本、编号、元数据;
embed_documents批量调用GPU生成向量;zip把编号、向量、元数据一一对应,封装成Qdrant专属PointStruct;- 缓冲区数量达到
UPSERT_BATCH_SIZE时执行client.upsert网络写入; set_postfix在进度条右下角实时展示当前入库进度;- 循环结束后把缓冲区剩下不足一批的数据收尾写入;
# 3.4 search检索方法:验证语义召回效果
def search(self, query: str, top_k: int = 3):
    print(f"\n🔍 检索问题:{query}")
    query_vec = self.embeddings.embed_query(query)

    results = self.client.query_points(
        collection_name=self.collection_name,
        query=query_vec,
        limit=top_k
    )

    hits = results.points
    print(f"✅ 检索到 {len(hits)} 条结果\n")
    for rank, hit in enumerate(hits, 1):
        score = hit.score
        payload = hit.payload
        page = payload["page"]
        breadcrumb = payload["breadcrumb"]
        content = payload["content"]

        print(f"===== 第{rank}名 | 相似度:{score:.4f} =====")
        print(f"📍 页码:{page} | 章节路径:{breadcrumb}")
        print(f"📖 正文片段:{content[:300]}...\n")
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
执行流程:
- 用户输入自然语言问题;
embed_query把问句转为向量;query_points传给Qdrant,在向量库内计算相似度,返回分数最高前3条;- 循环打印每条结果:相似度分数、对应页码、章节路径、原文片段; 用来验收:提问分红、净利润等问题,是否能精准匹配年报里对应的原文片段。
# 第四部分:程序入口main函数
def main():
    builder = VectorIndexBuilder(COLLECTION_NAME, EMBEDDING_MODEL_NAME)

    # 先放开注释执行入库,入库完成后注释掉,只跑检索测试
    builder.build_index(INPUT_JSON)

    # 年报适配测试问句,验收检索效果
    test_query = "2025年度利润分配分红方案是什么?"
    builder.search(test_query, top_k=3)

if __name__ == "__main__":
    main()
2
3
4
5
6
7
8
9
10
11
12
- 实例化向量入库对象;
- 先执行
build_index完成全量文本向量化入库; - 入库完毕自动执行测试检索语句,验证整套链路通顺;
if __name__ == "__main__":只有直接运行该文件时才执行main函数,被其他文件导入时不会自动执行。
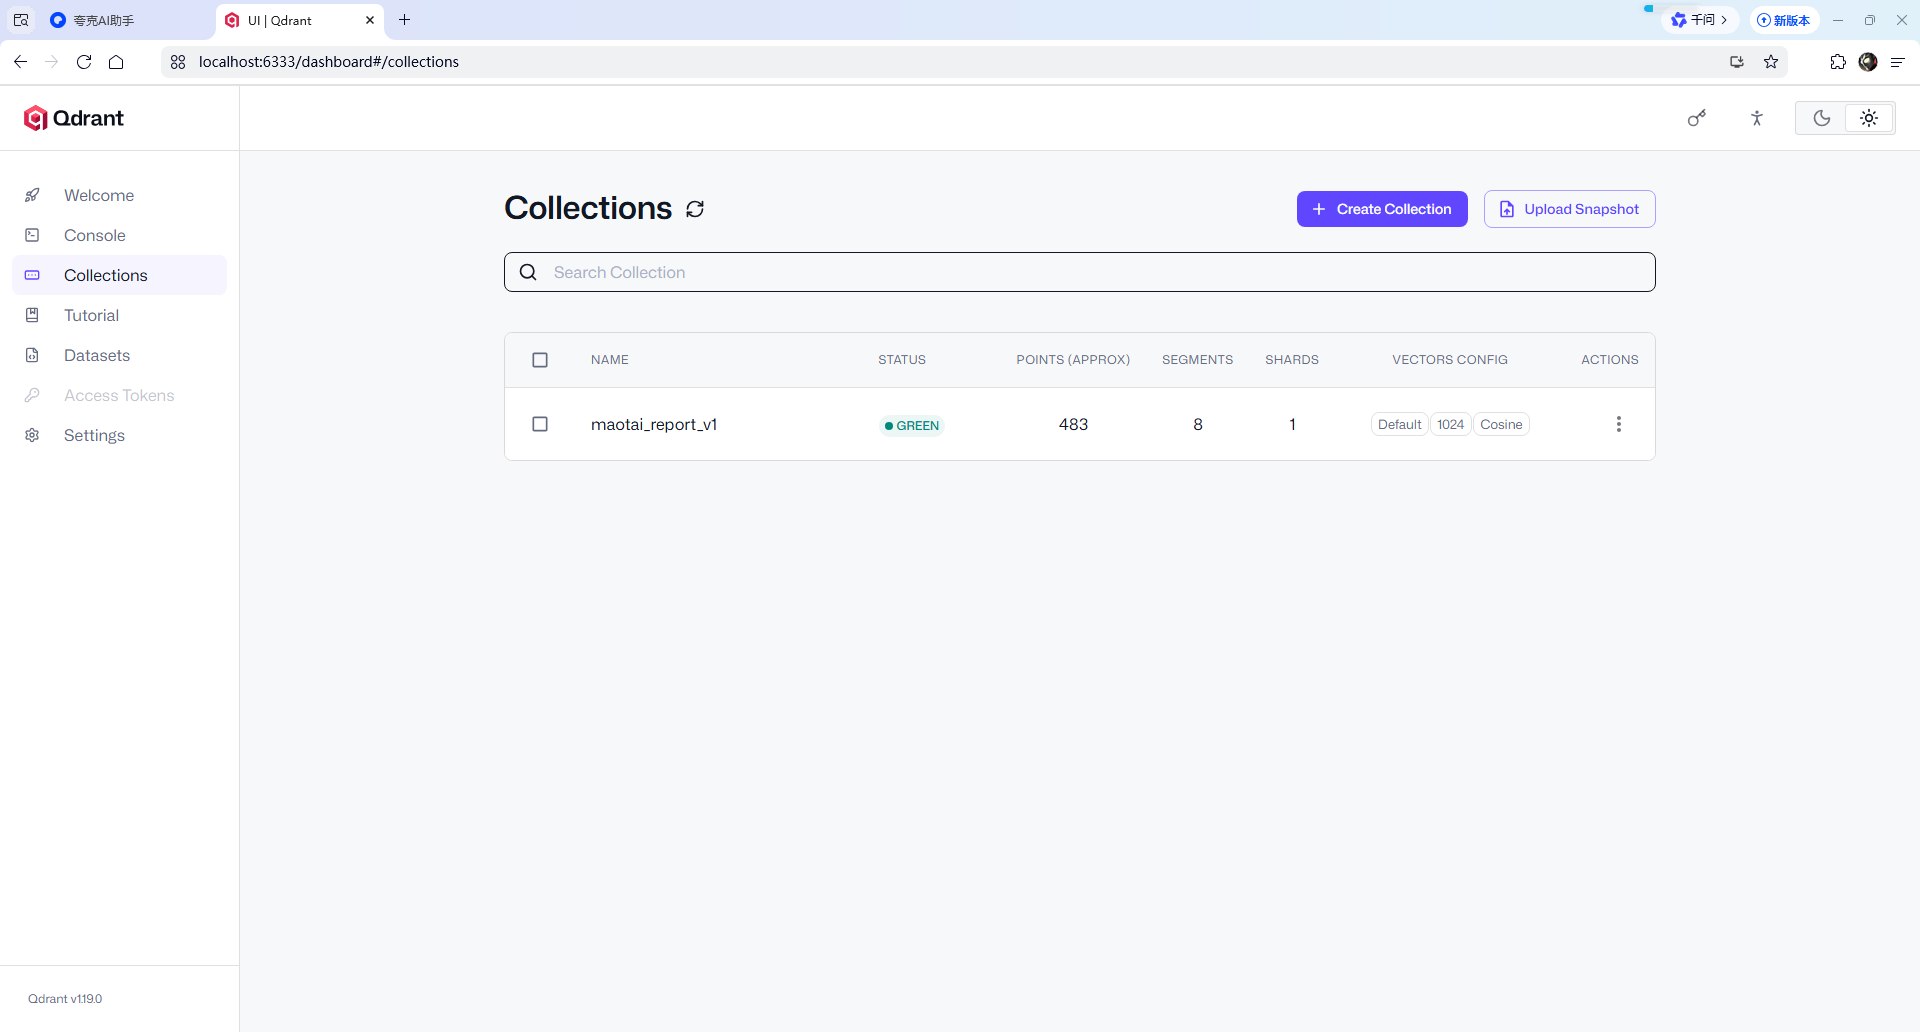
完成啦,现在看Qdrant的界面:
# 里程碑 4:构建知识图谱(Neo4j)—— 本阶段最硬核的挑战
目标:让系统具备“逻辑推理”的能力,提取出文档里的人名、公司名和它们之间的关系。
你需要完成:
- 编写 graph_builder.py。
- 调用大模型(如 Qwen 或 GPT),让它阅读文本,提取出 JSON 格式的实体(Entity)和关系(Relation)。
- 编写 Cypher 语句,将这些节点和关系写入 Neo4j。
- 验证:在 Neo4j 浏览器里输入查询语句,能画出一张包含几个节点和连线的网状图。
# Neo4j 到底能干啥、实际效果、天生短板
先分清:向量库 Qdrant 和 图数据库 Neo4j 核心分工
- Qdrant(向量检索)擅长的事
只做一件事:根据文字语义找相似的原文片段
举例子:
你提问:“分红方案是谁审核的?”
Qdrant 只会把包含 “董事会、分红、审议” 这几个词的段落文本丢给你,它不知道:
董事会、分红方案二者之间存在「审议」这个上下级逻辑关系,它看不到结构,只认得文字。
- Neo4j(知识图谱)擅长的事:抓实体 + 逻辑关联,做链式推理
把文档里零散的要素拆成「点」和「连线」:
- 节点(点):贵州茅台、董事会、2024 分红方案、股东大会
- 连线(关系):董事会→【审议】→分红方案、股东大会→【批准】→分红方案、茅台→【发布】→年报
# 它能做到向量库做不到的业务效果:
- 链路串联查询
执行一句 Cypher:
找到所有审批分红方案的全部机构以及先后流程图谱会自动梳理完整链条:董事会初审 → 股东大会终审,一步理清业务流程; 换成 Qdrant 只能一堆杂乱文本,需要你自己人工阅读梳理。 - 多层关联挖掘 例如:查 “参与分红决策的所有高管所在部门”,顺着关系层层跳转检索;
- 直观可视化 网页里直接拖拽节点,一眼看清谁和谁有关系,不用埋头翻几百页 PDF;
- 精准溯源 每一条关系绑定来源页码,查到这条审批关系来自年报 32 页原文。
# Neo4j 天生的局限(必须客观认清,避免你抱有不切实际的期待)
- 它不会自动读懂业务语义 Neo4j 本身只是一个存节点、存连线的数据库,不会自己看 PDF 抽实体和关系。抽取工作必须靠大模型 / 规则 / 人工完成,Neo4j 只负责存储、查询、画图。
- 纯大段原文全文检索非常拉胯 如果你需求只是 “找包含某句话的段落”,完全没必要上 Neo4j,Qdrant 效率高十倍;图谱适合结构化关联查询,不适合全文文本检索。
- 抽取质量决定图谱上限 大模型抽错实体、连错关系,图谱结果就一定是错的。年报里专业财务术语理解不到位,模型胡乱搭建关系,查出来的链路自然无效。
- 构建成本远高于向量库 向量入库一键跑完即可;图谱要抽取、清洗、去重、入库校验,流程更长。
前面我们已经安装并且启动了neo4j
- 打开浏览器进入 Neo4j 可视化操作页面
http://localhost:7474 (opens new window)
Username:neo4j
Password:12345678(你刚才命令里设置的密码)
# Cypher 最核心基础语法大全(0 基础,公式 + 例子)
- 节点语法
( ) 代表节点
- 最简空节点:
() - 带临时变量:
(n) - 带标签:
(n:Company) - 多标签:
(n:Company:Enterprise) - 带属性:
(n:Company{name:"茅台", addr:"遵义"})
变量只是当前语句内的代号,不会存进数据库。数据库永久保存的只有:标签、属性。
- 关系(连线)语法
-[ ]-> 代表有方向的关系(箭头非常重要,方向不能随便丢)
(a)-[r:HAS_DEPARTMENT]->(b)
a:起点节点变量-[ ]->:关系外壳,箭头指向目标r:关系的临时变量:HAS_DEPARTMENT:关系类型名,不能加引号,大写是习惯- 关系也可以带属性:
(a)-[r:HAS_DEPARTMENT{desc:"公司下设部门"}]->(b)
公式:
(起点变量)-[关系变量:关系类型{属性}]->(终点变量)
- 无箭头写法
(a)-[r]-(b)
查询的时候可以省略箭头,代表不管方向,两边都匹配;
但是 CREATE 创建关系必须写箭头->,关系是有方向的。
- MATCH 匹配(相当于 SQL 的 SELECT 查询)
用来在库里找到已经存在的节点 / 关系,不会新增数据。
MATCH (c:Company{name:"贵州茅台酒股份有限公司"})
RETURN c
2
MATCH:去数据库匹配符合条件的数据RETURN:把匹配到的结果返回展示,必须写,不然看不到结果。匹配两个节点,准备建关系
MATCH (c:Company{name:"贵州茅台酒股份有限公司"}), (d:Department{name:"董事会"})
CREATE (c)-[r:HAS_DEPARTMENT]->(d)
2
逻辑:先找到两个节点,再给它们创建连线。
- MERGE【重中之重,生产环境替代 CREATE】
CREATE:无脑新建,重复执行就重复造节点。
MERGE:有就复用,没有就新建,保证同一个实体只有 1 个节点。
MERGE (c:Company{name:"贵州茅台酒股份有限公司"})
SET c.industry = "白酒行业"
2
- 如果库里已经存在
label=Company并且name="贵州茅台酒股份有限公司"的节点 → 直接找到它,不会新建 - 如果不存在 → 自动 CREATE 新建节点
SET:给节点 / 关系新增、修改属性
✅ 你做年报图谱,所有实体入库一律用 MERGE,禁止用 CREATE,避免大量重复实体。
- SET 修改属性
给节点或者关系追加 / 修改属性
MATCH (c:Company{name:"贵州茅台酒股份有限公司"})
SET c.industry = "高端白酒"
2
- DELETE / DETACH DELETE 删除
MATCH (n) DETACH DELETE n
DELETE n:删除节点;如果节点还有连线(关系),直接删会报错DETACH DELETE n:先删除该节点所有相连的关系,再删除节点。测试清空数据库就用这条。
- RETURN 返回结果
RETURN 用来指定返回什么内容,可以返回节点、属性、变量。
MATCH (c:Company)
RETURN c.name, c.addr
2
只返回名字和地址,不返回完整节点图形。
- 路径 path(查看完整网络图)
path=(a)-[r]-(b) 把一整条 “节点 - 关系 - 节点” 包装成 path 变量,return path 就出来可视化网络图。
MATCH path=(a)-[r]-(b)
RETURN path
2
接下来手把手网页端练 Cypher
实操1:创建第一个节点
输入框粘贴语句,点击右上角执行▶
CREATE (c:Company{name:"贵州茅台酒股份有限公司", addr:"贵州遵义"})
- 查看数据
MATCH (n) RETURN n
页面出现圆形节点,双击可以查看里面的 name、addr 信息。
实操 2:新建第二个节点 + 建立关系
CREATE (dept:Department{name:"董事会", duty:"审议分红方案"})
构建两个节点之间的连线:
MATCH (c:Company{name:"贵州茅台酒股份有限公司"}), (d:Department{name:"董事会"})
CREATE (c)-[r:HAS_DEPARTMENT]->(d)
SET r.info = "茅台下设董事会机构"
2
3
执行查看整张图谱:
MATCH path=(a)-[rel]-(b) RETURN path
页面出现两个圆圈 + 带箭头连线,你的第一张图谱完成。
实操 3:核心命令 MERGE(正式入库必须用,杜绝重复节点)
MERGE (c:Company{name:"贵州茅台酒股份有限公司"})
SET c.industry = "高端白酒"
2
- 作用:
数据库里已经存在同名同标签节点 → 只更新属性,不会新建; 不存在就自动新建节点。
- 为什么不用 CREATE:
多次执行 CREATE 会生成一堆一模一样的 “贵州茅台” 节点,数据冗余混乱;MERGE 保证一个实体全局唯一。
实操 4:清空全部测试数据
MATCH (n) DETACH DELETE n
DETACH 先删掉所有关联的关系,再删除节点,否则节点被连线锁住无法删除。
- Python 连接 Docker 里的 Neo4j(重点,后续代码自动入库)
- 安装依赖包
打开你的 Python 终端:
pip install neo4j python-dotenv
- 新建项目里的
.env配置文件
NEO4J_URI=bolt://localhost:7687
NEO4J_USER=neo4j
NEO4J_PASSWORD=12345678
2
3
bolt://localhost:7687 固定地址,Docker 端口已经映射到本机,不用改。
核心基础概念
GraphDatabase.driver():创建数据库连接驱动器(只创建一次,全局复用)- Session(会话):执行 Cypher 语句的载体
- Transaction(事务):推荐优先用事务,支持回滚,数据更安全
最简连接模板(测试连通性)
from neo4j import GraphDatabase
from dotenv import load_dotenv
import os

load_dotenv()

uri = os.getenv("NEO4J_URI")
user = os.getenv("NEO4J_USER")
pwd = os.getenv("NEO4J_PASSWORD")

# 2. 创建驱动【全局只初始化一次!不要循环反复创建driver】
driver = GraphDatabase.driver(uri, auth=(user, pwd))

# 3. 连通测试
def test_connect():
    # with语法自动关闭会话,不用手动session.close()
    with driver.session() as session:
        result = session.run("RETURN '连接Docker-Neo4j成功' AS msg")
        # 读取单行结果
        record = result.single()
        print(record["msg"])

if __name__ == "__main__":
    test_connect()
    # 程序结束关闭驱动
    driver.close()
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
运行代码,控制台打印连接成功,代表 Python 和 Docker 中的 Neo4j 打通。
- 官方标准 API 分类(最常用全套)
- 重要规范
❌ 不要在循环里
GraphDatabase.driver(),驱动只创建 1 个 ✅ 驱动全局单例,反复复用 session 执行语句
- 执行 Cypher 基础:session.run ()
session.run(cypher语句, 参数1=值, 参数2=值...)
✅ 强制使用参数传参,不要字符串拼接!防止语法错误、注入风险
- 错误示范(千万别写)
# 禁止f-string拼接内容!极易出错
name = "贵州茅台"
cypher = f'MERGE (n{{name:"{name}"}})'
2
3
- ✅ 正确示范(使用 $ 占位符)
cypher = "MERGE (n:Company{name:$company_name})"
session.run(cypher, company_name="贵州茅台酒股份有限公司")
2
- 创建 / 更新节点(MERGE,正式业务推荐)
封装通用函数,可以直接复制使用
def create_node(label: str, name: str, props: dict):
    """
    label: 节点标签 例如 "Company"
    name: 实体唯一标识
    props: 额外属性字典
    """
    cypher = """
        MERGE (n:{label}{{name:$name}})
        SET n += $props
    """.format(label=label)

    with driver.session() as session:
        session.run(cypher, name=name, props=props)

# 调用示例
create_node(
    label="Company",
    name="贵州茅台酒股份有限公司",
    props={"addr": "贵州遵义", "industry": "白酒"}
)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
- 创建 / 更新关系 MERGE(不会重复生成连线)
def create_relation(
    head_label: str, head_name: str,
    rel_type: str,
    tail_label: str, tail_name: str,
    rel_props: dict
):
    cypher = """
    MATCH (a:{hl}{{name:$hn}}), (b:{tl}{{name:$tn}})
    MERGE (a)-[r:{rt}]->(b)
    SET r += $r_props
    """.format(hl=head_label, tl=tail_label, rt=rel_type)

    with driver.session() as session:
        session.run(
            cypher,
            hn=head_name,
            tn=tail_name,
            r_props=rel_props
        )

# 调用示例
create_relation(
    head_label="Company",
    head_name="贵州茅台酒股份有限公司",
    rel_type="HAS_DEPARTMENT",
    tail_label="Department",
    tail_name="董事会",
    rel_props={"source_page": 32}
)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
- 查询数据 API(读取节点、关系)
方式 1:查询单个节点,获取属性
def query_company(company_name):
    cypher = """
        MATCH (c:Company{name:$name})
        RETURN c.name AS name, c.addr AS addr, c.industry AS industry
    """
    with driver.session() as session:
        res = session.run(cypher, name=company_name)
        # 获取单条结果
        record = res.single()
        if record:
            return {
                "name": record["name"],
                "addr": record["addr"],
                "industry": record["industry"]
            }
        return None

print(query_company("贵州茅台酒股份有限公司"))
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
方式 2:多条数据循环遍历(查询全部公司)
def query_all_company():
    cypher = "MATCH (c:Company) RETURN c.name AS name"
    result_list = []
    with driver.session() as session:
        res = session.run(cypher)
        # 循环所有结果
        for record in res:
            result_list.append(record["name"])
    return result_list

print(query_all_company())
2
3
4
5
6
7
8
9
10
11
方式 3:查询某个实体的全部关联节点(图谱链路查询)
def query_relation_graph(entity_name):
    cypher = """
        MATCH path=(n{name:$name})-[r]-(m)
        RETURN path
    """
    with driver.session() as session:
        res = session.run(cypher, name=entity_name)
        for record in res:
            path = record["path"]
            print(path)
2
3
4
5
6
7
8
9
10
- 删除数据 API
删除指定节点(连带关系)
def del_node(label, name):
    cypher = """
        MATCH (n:{label}{{name:$name}})
        DETACH DELETE n
    """.format(label=label)
    with driver.session() as session:
        session.run(cypher, name=name)

# 清空全部数据(测试环境慎用!)
def clear_all():
    with driver.session() as session:
        session.run("MATCH (n) DETACH DELETE n")
2
3
4
5
6
7
8
9
10
11
12
- Result 结果对象核心常用方法(重点 API)
执行 session.run() 返回 Result 对象
.single()→ 获取第一条记录,没有返回None.fetch()→ 获取下一条记录.records()→ 返回所有记录列表.data()→ 超级好用!直接把结果转为字典列表
# .data()示例,极简写法
with driver.session() as session:
    res = session.run("MATCH (c:Company) RETURN c.name, c.addr")
    data = res.data()
print(data)
# 输出格式 [{'c.name':'xxx','c.addr':'xxx'}, {...}]
2
3
4
5
6
# 里程碑4思路原理
最终目标
年报是非结构化自然语言文本,电脑无法自动识别【谁、哪个公司、哪个部门、彼此是什么关系】。
我们希望把文字变成结构化的网络:实体(节点)+ 关系(连线),存入 Neo4j 知识图谱,后续可以实现:关联检索、事理推理、溯源年报原文。整体完整链路 & 每一步「做什么 + 为什么这么做」
原始年报PDF
    ↓【parse_pdf.py】PDF解析 → markdown文本
    作用:二进制PDF不能直接读取,转成纯文本格式
    ↓【split_md.py】文本切片,输出 chunked_output.json ✅已经完成
    作用:
    1. 年报文本上万字,超出大模型上下文窗口,一次性塞进去会丢失信息;
    2. 分段处理,降低单次LLM消耗,出错可以局部重试,不用全部重来;
    3. **切片文件复用**:同一套chunk,一边给向量数据库做RAG,一边用来构建知识图谱,避免重复切割文档。

chunked_output.json(数组,每条包含 content正文、page页码、breadcrumb章节)
    ↓【graph_builder.py 开始工作,本阶段核心代码】
    步骤1:读取chunked_output.json,循环取出每一段文本
    步骤2:把单段文本 + 严格规范Prompt 发给大模型
    👉为什么要用Prompt强制JSON?
    大模型天生擅长自由文本聊天,如果不限制格式,返回杂乱中文,程序无法解析;强制输出固定JSON结构,Python代码可以稳定读取实体、关系。
    步骤3:捕获大模型返回JSON,做异常容错清洗
    👉为什么要容错?大模型偶尔会附带```json、注释、多余文字,直接json.loads会程序崩溃。
    步骤4:解析JSON得到实体列表、关系列表
    步骤5:【顺序重点!】先批量写入实体节点,再写入实体关系
    👉为什么顺序不能颠倒?
    Neo4j创建连线(关系)的前提:数据库里必须已经存在头实体、尾实体两个节点。先建关系后建节点 → 匹配不到节点,连线直接创建失败!
    步骤6:使用MERGE语法写入Neo4j,禁止CREATE
    👉为什么不用CREATE?
    CREATE每次执行都新建节点。同一家公司多次出现在不同文本块,会生成几十个重复“贵州茅台”节点。
    MERGE逻辑:存在则复用、不存在才新建,保证一个实体数据库内只存在唯一节点。
    步骤7:全部处理完毕,在Neo4j Browser执行Cypher,可视化图谱验证结果
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
区分两个极易混淆概念(重中之重)
chunked_output.json:原始素材
只有一段一段的年报文字,没有知识结构,不能直接导入图谱;只能作为大模型的阅读材料。- LLM 输出的
{"entities":[],"relations":[]}:结构化知识
这是中间产物,拥有实体名称、实体类型、实体之间的关联关系,这部分信息才可以翻译成 Cypher 存入 Neo4j。
# 完整代码
import os
import re
import time
import json
from dotenv import load_dotenv
from neo4j import GraphDatabase
from openai import OpenAI

# 加载.env配置
load_dotenv()

# ====================== Neo4j 配置 ======================
NEO4J_URI = os.getenv("NEO4J_URI", "bolt://127.0.0.1:7687")
NEO4J_USER = os.getenv("NEO4J_USER", "neo4j")
NEO4J_PASSWORD = os.getenv("NEO4J_PASSWORD")

# ====================== 阿里云百炼 Qwen API 配置 ======================
DASHSCOPE_API_KEY = os.getenv("DASHSCOPE_API_KEY")
MODEL_NAME = "qwen-turbo"
client = OpenAI(
    api_key=DASHSCOPE_API_KEY,
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1"
)

# 建立Neo4j连接
driver = GraphDatabase.driver(NEO4J_URI, auth=(NEO4J_USER, NEO4J_PASSWORD))


def create_entity_node(label: str, name: str, props: dict):
    """创建/合并实体节点(修复Cypher {}冲突)"""
    cypher = """
        MERGE (n:`{label}` {name: $name})
        SET n += $props
    """.replace("{label}", label)

    with driver.session() as session:
        session.run(cypher, name=name, props=props)


def create_relationship(head_name: str, rel_type: str, tail_name: str, rel_props: dict):
    """创建/合并实体关系"""
    cypher = """
        MATCH (a {name: $head_name}), (b {name: $tail_name})
        MERGE (a)-[r:`{rel_type}`]->(b)
        SET r += $rel_props
    """.replace("{rel_type}", rel_type)

    with driver.session() as session:
        session.run(
            cypher,
            head_name=head_name,
            tail_name=tail_name,
            rel_props=rel_props
        )


def llm_extract_entities_relation(text: str):
    prompt = """
你是专业年报实体关系抽取专家,请严格遵守所有规则:
1. 最终只输出纯JSON,禁止```标记、多余说明文字;
2. 实体分类label仅允许选择:Company(公司)、Person(自然人)、Department(部门/机构)
3. 仔细阅读文本,尽可能挖掘实体之间存在的关联;
   关系rel统一使用大写英文,示例参考:
   HAS_DEPARTMENT(公司拥有部门)、WORK_FOR(任职于)、DIRECTOR_OF(担任董事)
4. 禁止编造文本不存在的信息;没有识别内容使用空数组。

标准格式示例:
{
    "entities": [
        {"name":"贵州茅台酒股份有限公司", "label":"Company"},
        {"name":"董事会", "label":"Department"}
    ],
    "relations": [
        {"head":"贵州茅台酒股份有限公司", "rel":"HAS_DEPARTMENT", "tail":"董事会"}
    ]
}
"""
    user_content = f"待分析年报文本:\n{text}"

    messages = [
        {"role": "system", "content": prompt},
        {"role": "user", "content": user_content}
    ]

    max_retry = 2
    for attempt in range(max_retry):
        try:
            response = client.chat.completions.create(
                model=MODEL_NAME,
                messages=messages,
                temperature=0.0,
                response_format={"type": "json_object"},
                timeout=120
            )
            content = response.choices[0].message.content
            usage = response.usage
            print(f"🔹 Token消耗 | 输入:{usage.prompt_tokens} 输出:{usage.completion_tokens} 合计:{usage.total_tokens}")
            print(f"模型原始返回:\n{content}\n")

            match = re.search(r"\{[\s\S]*\}", content)
            if match:
                json_str = match.group(0)
                data = json.loads(json_str)
                entities = data.get("entities", [])
                relations = data.get("relations", [])
                return entities, relations
            else:
                print("⚠ 未匹配到合法JSON结构")
                return [], []

        except Exception as e:
            print(f"【第{attempt+1}次请求失败】异常:{str(e)}")
            if attempt < max_retry - 1:
                print("等待3秒后重试...")
                time.sleep(3)
    print("多次重试仍然失败,放弃本条")
    return [], []


def load_all_chunks():
    """读取切片json,确认文件名和路径正确"""
    with open("chunked_output.json", "r", encoding="utf-8") as f:
        return json.load(f)


def run_build_graph():
    chunk_list = load_all_chunks()
    print(f"成功读取切片总数:{len(chunk_list)}")

    # =========【调试关键】初次运行一定要开启!只测试第一条文本 =========
    # 调试成功、确认没有报错之后,再删除下面这一行,全量运行
    # chunk_list = chunk_list[0:1]

    for idx, chunk in enumerate(chunk_list):
        print(f"\n=====正在处理 {idx+1}/{len(chunk_list)} =====")
        chunk_content = chunk["content"]
        chunk_page = chunk.get("page", idx + 1)

        if not chunk_content.strip():
            print("文本为空,跳过")
            continue

        entities, relations = llm_extract_entities_relation(chunk_content)
        print(f"本段抽取实体:{len(entities)}个,关系:{len(relations)}个")

        # 写入节点
        for ent in entities:
            create_entity_node(
                label=ent["label"],
                name=ent["name"],
                props={"source_page": chunk_page}
            )

        # 写入关系
        for rel in relations:
            create_relationship(
                head_name=rel["head"],
                rel_type=rel["rel"],
                tail_name=rel["tail"],
                rel_props={"source_page": chunk_page}
            )

        time.sleep(1.2)  # 限流,防止调用频率超限

    print("\n========全部文本处理完成========")
    driver.close()


if __name__ == "__main__":
    run_build_graph()
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
145
146
147
148
149
150
151
152
153
154
155
156
157
158
159
160
161
162
163
164
165
166
167
168
169
170
171
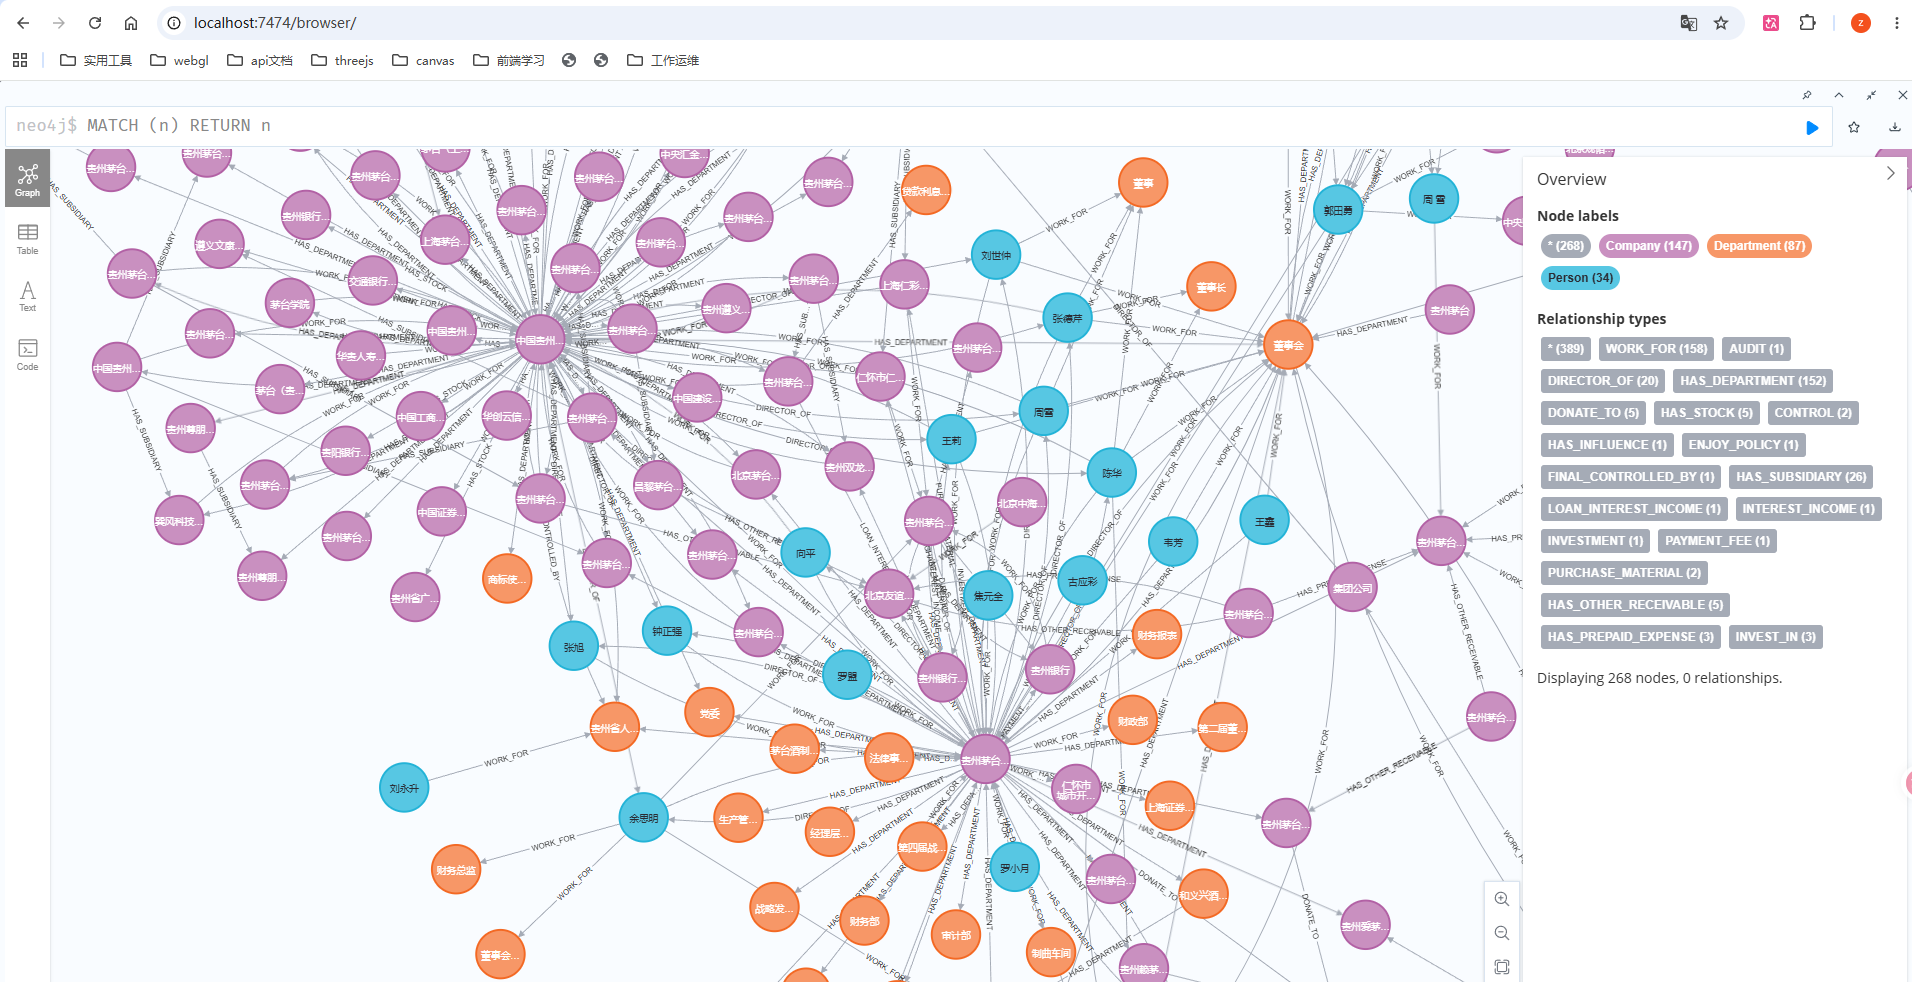
其实之前我用过ollama本地部署的模型,但是抽取准确度不高,而且速度慢,最后我还是用了在线的付费api
# 代码拆解
# 一、头部导入模块
import os
import re
import time
import json
from dotenv import load_dotenv
from neo4j import GraphDatabase
from openai import OpenAI
2
3
4
5
6
7
os:读取系统环境变量re:正则表达式,兜底提取JSON(防止模型额外输出文字)time:休眠限流、失败重试等待json:读取本地切片文件、解析模型返回的JSON字符串load_dotenv:读取项目下.env配置文件,密钥不要硬写在代码里(安全规范)GraphDatabase:Neo4j官方驱动,操作图数据库OpenAI:兼容OpenAI协议客户端;阿里云百炼、DeepSeek都支持这套兼容接口,所以可以直接复用,不用单独装阿里云SDK
行业规范:API密钥、数据库密码绝对不能写死在py文件,统一放
.env,.env不提交git,防止密钥泄露。
# 二、加载环境变量 + 初始化配置
# 加载.env配置
load_dotenv()

# ====================== Neo4j 配置 ======================
NEO4J_URI = os.getenv("NEO4J_URI", "bolt://127.0.0.1:7687")
NEO4J_USER = os.getenv("NEO4J_USER", "neo4j")
NEO4J_PASSWORD = os.getenv("NEO4J_PASSWORD")

# ====================== 阿里云百炼 Qwen API 配置 ======================
DASHSCOPE_API_KEY = os.getenv("DASHSCOPE_API_KEY")
MODEL_NAME = "qwen-turbo"
client = OpenAI(
    api_key=DASHSCOPE_API_KEY,
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1"
)

# 建立Neo4j连接
driver = GraphDatabase.driver(NEO4J_URI, auth=(NEO4J_USER, NEO4J_PASSWORD))
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
load_dotenv():自动读取同级目录.env文件,把键值载入环境变量os.getenv(键, 默认值): 如果.env中不存在这个key,使用后面默认值;灵活兼容本地调试。- OpenAI客户端重点知识点:
- 原生OpenAI客户端默认访问
api.openai.com; - 通过
base_url指向阿里云兼容接口地址,实现一套代码切换多家大模型服务商(DeepSeek、月之暗面、通义千问全都通用)
- 原生OpenAI客户端默认访问
driver = GraphDatabase.driver(...)创建数据库连接驱动(全局单例),不要在循环内反复创建,频繁创建销毁连接性能极差。
重要:driver创建成功≠数据库连通;只有执行session.run()发送Cypher时才真正通信。
# 三、函数1:create_entity_node 创建/合并实体节点
def create_entity_node(label: str, name: str, props: dict):
    """创建/合并实体节点(修复Cypher {}冲突)"""
    cypher = """
        MERGE (n:`{label}` {name: $name})
        SET n += $props
    """.replace("{label}", label)

    with driver.session() as session:
        session.run(cypher, name=name, props=props)
2
3
4
5
6
7
8
9
- 逐个拆解知识点
MERGE【Neo4j核心语法,重中之重】CREATE:直接新建节点,重复执行会产生大量重复同名节点;MERGE:存在则匹配,不存在则创建(幂等操作) 适合你的场景:同一个人名多次出现在不同年报切片,只保留一个节点,不重复新建。
`{label}`反引号作用 实体标签Company/Person/Department,如果标签是英文关键字,用反引号包裹防止语法报错。为什么不用
.format(),改用.replace()?历史坑! Cypher语句内部大量使用{}作为参数占位符:{name}如果使用"xxx{}xxx".format(),Python会把Cypher里的{name}识别为格式化变量,直接抛出KeyError,也就是我之前遇到的崩溃! 所以标签/关系名称只用replace替换;普通查询参数使用驱动自带参数绑定$变量。参数绑定
$name $props❌ 绝对不要手动字符串拼接文本写入Cypher → Cypher注入风险 ✅ 驱动提供的参数绑定是安全方案,自动转义特殊字符(人名带括号、顿号等不会语法报错)。SET n += $props+=代表追加属性;如果节点已经存在,不会覆盖原有属性,只会新增/更新key。with driver.session() as session:with上下文管理器,代码块结束自动关闭会话,避免数据库会话泄漏。
# 四、函数2:create_relationship 创建/合并关系
def create_relationship(head_name: str, rel_type: str, tail_name: str, rel_props: dict):
    """创建/合并实体关系"""
    cypher = """
        MATCH (a {name: $head_name}), (b {name: $tail_name})
        MERGE (a)-[r:`{rel_type}`]->(b)
        SET r += $rel_props
    """.replace("{rel_type}", rel_type)

    with driver.session() as session:
        session.run(
            cypher,
            head_name=head_name,
            tail_name=tail_name,
            rel_props=rel_props
        )
2
3
4
5
6
7
8
9
10
11
12
13
14
15
执行逻辑顺序:
MATCH (a {name:$head_name}), (b {name:$tail_name})根据name匹配两个实体节点(头实体、尾实体)⚠️ 隐藏风险:如果数据库找不到a或者b节点,整条语句直接不执行,不会创建悬空关系。
MERGE (a)-[r:WORK_FOR]->(b)匹配a指向b的这条关系,不存在则新建;避免重复创建多条一模一样的任职连线。- 关系类型
WORK_FOR/HAS_DEPARTMENT是固定英文,同样用反引号包裹、replace注入。
# 五、核心函数 llm_extract_entities_relation(整个项目最重要)
作用:接收一段年报文本 → 调用千问API → 提取实体、关系,返回结构化字典
def llm_extract_entities_relation(text: str):
    prompt = """
你是专业年报实体关系抽取专家,请严格遵守所有规则:
1. 最终只输出纯JSON,禁止```标记、多余说明文字;
2. 实体分类label仅允许选择:Company(公司)、Person(自然人)、Department(部门/机构)
3. 仔细阅读文本,尽可能挖掘实体之间存在的关联;
   关系rel统一使用大写英文,示例参考:
   HAS_DEPARTMENT(公司拥有部门)、WORK_FOR(任职于)、DIRECTOR_OF(担任董事)
4. 禁止编造文本不存在的信息;没有识别内容使用空数组。

标准格式示例:
{
    "entities": [
        {"name":"贵州茅台酒股份有限公司", "label":"Company"},
        {"name":"董事会", "label":"Department"}
    ],
    "relations": [
        {"head":"贵州茅台酒股份有限公司", "rel":"HAS_DEPARTMENT", "tail":"董事会"}
    ]
}
"""
    user_content = f"待分析年报文本:\n{text}"

    messages = [
        {"role": "system", "content": prompt},
        {"role": "user", "content": user_content}
    ]

    max_retry = 2
    for attempt in range(max_retry):
        try:
            response = client.chat.completions.create(
                model=MODEL_NAME,
                messages=messages,
                temperature=0.0,
                response_format={"type": "json_object"},
                timeout=120
            )
            content = response.choices[0].message.content
            usage = response.usage
            print(f"🔹 Token消耗 | 输入:{usage.prompt_tokens} 输出:{usage.completion_tokens} 合计:{usage.total_tokens}")
            print(f"模型原始返回:\n{content}\n")

            match = re.search(r"\{[\s\S]*\}", content)
            if match:
                json_str = match.group(0)
                data = json.loads(json_str)
                entities = data.get("entities", [])
                relations = data.get("relations", [])
                return entities, relations
            else:
                print("⚠ 未匹配到合法JSON结构")
                return [], []

        except Exception as e:
            print(f"【第{attempt+1}次请求失败】异常:{str(e)}")
            if attempt < max_retry - 1:
                print("等待3秒后重试...")
                time.sleep(3)
    print("多次重试仍然失败,放弃本条")
    return [], []
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
- 分层拆解知识点
System Prompt(系统提示词)
- 设定模型身份、任务边界、输出格式、禁止行为、标准样例;
- few-shot小样本提示:附上标准JSON样例,极大提升模型格式服从性;
- 强约束:禁止幻觉、限定实体类型、固定关系命名规范。
messages消息列表规范(OpenAI协议标准格式)system:全局角色指令;user:用户当前提问文本; 对话顺序不能乱。
请求参数详解
model=MODEL_NAME,
messages=messages,
temperature=0.0,
response_format={"type": "json_object"},
timeout=120
1
2
3
4
5temperature=0.0:温度越低,创造性越低、输出越确定;抽取任务必须设0,减少随机编造;response_format={"type": "json_object"}:千问原生强制JSON模式,大幅减少模型输出多余文字;timeout=120:超时时间,网络差、长文本推理慢时防止程序卡死。
响应解析
response.choices[0].message.content:大模型返回文本;response.usage:计费统计对象,包含输入、输出token,用来估算费用。
re.search(r"\{[\s\S]*\}", content)兜底正则!非常关键 哪怕开启json_object,偶尔模型还是会前后附带注释、换行;正则自动抓取第一个{ }内完整JSON字符串,防止json.loads()直接崩溃。异常重试机制(工业批量爬虫/抽取标准写法)
max_retry = 2
for attempt in range(max_retry):
    try:
        # 调用API
    except Exception as e:
        # 报错,等待后重试
1
2
3
4
5
6遇到网络超时、接口限流、瞬时服务故障,自动重试;多次失败直接返回空列表,不会整条程序崩溃退出。
data.get("entities", [])不用data["entities"],使用.get(); 防止模型返回json缺少key,触发KeyError程序终止,找不到key就返回空列表。
# 六、load_all_chunks 读取本地切片文件
def load_all_chunks():
    """读取切片json,确认文件名和路径正确"""
    with open("chunked_output.json", "r", encoding="utf-8") as f:
        return json.load(f)
2
3
4
encoding="utf-8":Windows系统下读取中文json必须加,否则中文乱码报错;json.load(f):把文件中的JSON数组加载为Python list;- 文件格式要求:
[
  {"content":"年报文本片段","page":5},
  {"content":"第二段文本","page":6}
]
2
3
4
每条对象必须存在content字段,代码依赖此字段读取文本。
# 七、主调度函数 run_build_graph(整个程序流程控制器)
def run_build_graph():
    chunk_list = load_all_chunks()
    print(f"成功读取切片总数:{len(chunk_list)}")

    # =========【调试关键】初次运行一定要开启!只测试第一条文本 =========
    # 调试成功、确认没有报错之后,再删除下面这一行,全量运行
    # chunk_list = chunk_list[0:1]

    for idx, chunk in enumerate(chunk_list):
        print(f"\n=====正在处理 {idx+1}/{len(chunk_list)} =====")
        chunk_content = chunk["content"]
        chunk_page = chunk.get("page", idx + 1)

        if not chunk_content.strip():
            print("文本为空,跳过")
            continue

        entities, relations = llm_extract_entities_relation(chunk_content)
        print(f"本段抽取实体:{len(entities)}个,关系:{len(relations)}个")

        # 写入节点
        for ent in entities:
            create_entity_node(
                label=ent["label"],
                name=ent["name"],
                props={"source_page": chunk_page}
            )

        # 写入关系
        for rel in relations:
            create_relationship(
                head_name=rel["head"],
                rel_type=rel["rel"],
                tail_name=rel["tail"],
                rel_props={"source_page": chunk_page}
            )

        time.sleep(1.2)  # 限流,防止调用频率超限

    print("\n========全部文本处理完成========")
    driver.close()
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
# 执行流程分步
- 读取全部文本切片列表;
- 调试开关
chunk_list = chunk_list[0:1]只跑第一条测试,验证API、入库、格式全部正常,再放开批量跑,避免一次性消耗大量token; enumerate:同时拿到下标idx和切片内容,用来打印进度1/483、2/483;if not chunk_content.strip():过滤空白切片,无用文本不调用API,节约token;- 调用大模型抽取实体、关系;
- 循环entities,批量写入Neo4j节点;
- 循环relations,批量写入Neo4j关系;
time.sleep(1.2)请求之间休眠 作用:限流,防止短时间大量请求触发阿里云API频率限制(429报错);- 全部循环结束,
driver.close()关闭数据库连接,释放资源。
# 八、完整数据流总图
chunked_output.json
        ↓
load_all_chunks() → Python切片列表
        ↓
for循环逐条取出文本
        ↓
llm_extract_entities_relation()
        ├→ 组装prompt + 用户文本
        ├→ http请求阿里云通义千问API
        ├→ 获取JSON结果,正则清洗
        └→ 返回 entities[] 、relations[]
        ↓
循环entities → create_entity_node() → Neo4j创建/合并节点
        ↓
循环relations → create_relationship() → Neo4j创建/合并连线
        ↓
sleep休眠 → 进入下一条切片
循环结束 → 关闭数据库连接
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
# 2、需要重点记住的工程经验(踩坑总结)
- Cypher和Python字符串
{}冲突,Cypher动态标签/关系不要使用format; - 操作数据库优先
MERGE而不是CREATE,避免重复节点; - 所有外部API调用必须加:超时 + 异常捕获 + 自动重试;
- 结构化抽取任务
temperature=0+ 开启模型原生JSON模式; - 密钥禁止硬编码,统一.env管理;
- 批量任务先单条调试,确认无误再全量运行,节约token与时间;
- 永远使用驱动参数绑定
$var,杜绝Cypher注入; - 模型输出不要直接loads,增加正则兜底,防止格式异常程序崩溃。
现在阶段一完美完成,可以继续阶段二啦